

算法错题本
区间dp
P1880 石子合并
题目描述
在一个圆形操场的四周摆放 堆石子,现要将石子有次序地合并成一堆,规定每次只能选相邻的 堆合并成新的一堆,并将新的一堆的石子数,记为该次合并的得分。
试设计出一个算法,计算出将 堆石子合并成 堆的最小得分和最大得分。
输入格式
数据的第 行是正整数 ,表示有 堆石子。
第 行有 个整数,第 个整数 表示第 堆石子的个数。
输出格式
输出共 行,第 行为最小得分,第 行为最大得分。
输入 #1
44 5 9 4输出 #1
4354说明/提示
,。
题解
问题分析
DP定义
-
big[left][right]:合并区间[left, right]的最大代价 -
sm[left][right]:合并区间[left, right]的最小代价 -
f[i]:前缀和,快速计算区间和状态转移
对于区间[left, right],枚举分割点w:
代价 = 左区间代价 + 右区间代价 + 当前合并代价当前合并代价 = 区间石子总数 = f[right] - f[left-1]初始化
- 单堆石子合并代价为0:
big[i][i] = sm[i][i] = 0
结果提取
遍历所有长度为n的区间,取最小和最大值。
时间复杂度
- O(n³),适用于n≤200的情况
AC代码
#include<iostream>#include<cstring>using namespace std;const int N = 210;int a[N];//存数据int f[N];//前缀和int big[N][N];//长度i到j的最大代价int sm[N][N];//长度i到j的最小代价
int main(){ int n; cin >> n; // 读取数据并处理环形 for (int i = 1; i <= n; i++) { cin >> a[i]; a[i + n] = a[i]; // 环形处理:复制一遍数组 }
int m = n * 2; // 扩展后的数组长度 // 计算前缀和,用于快速求区间和 for (int i = 1; i <= m; i++) { f[i] = a[i] + f[i - 1]; // f[i]表示前i堆石子的总重量 }
// 初始化DP数组 memset(big, -0x3f, sizeof big); // 最大值初始化为负无穷 memset(sm, 0x3f, sizeof sm); // 最小值初始化为正无穷
// 初始化基础情况:单堆石子合并代价为0 for (int i = 1; i <= m; i++) { big[i][i] = 0; sm[i][i] = 0; }
// 区间DP:枚举区间长度 for (int len = 1; len <= n; len++) // 只需要计算到长度为n的区间 { for (int left = 1; len + left - 1 <= m; left++) // 枚举区间起点 { int right = len + left - 1; // 区间终点 // 枚举分割点,将区间分为[left, w]和[w+1, right] for (int w = left; w < right; w++) { // 状态转移方程: // 合并代价 = 左区间代价 + 右区间代价 + 当前合并的代价(区间石子总数) big[left][right] = max(big[left][right], big[left][w] + big[w + 1][right] + f[right] - f[left - 1]); sm[left][right] = min(sm[left][right], sm[left][w] + sm[w + 1][right] + f[right] - f[left - 1]); } } }
// 在环形中找最优解 int maxret = -0x3f3f3f3f; // 最大代价 int minret = 0x3f3f3f3f; // 最小代价 // 遍历所有可能的起点,区间长度为n for (int i = 1; i <= n; i++) { maxret = max(maxret, big[i][i + n - 1]); // 更新最大代价 minret = min(minret, sm[i][i + n - 1]); // 更新最小代价 }
cout << minret << endl << maxret << endl; return 0;}P9232 更小的数
题目描述
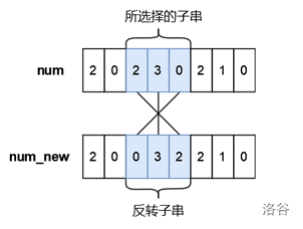
小蓝有一个长度均为 且仅由数字字符 组成的字符串,下标从 到 ,你可以将其视作是一个具有 位的十进制数字 ,小蓝可以从 中选出一段连续的子串并将子串进行反转,最多反转一次。小蓝想要将选出的子串进行反转后再放入原位置处得到的新的数字 满足条件 ,请你帮他计算下一共有多少种不同的子串选择方案,只要两个子串在 中的位置不完全相同我们就视作是不同的方案。
注意,我们允许前导零的存在,即数字的最高位可以是 ,这是合法的。
输入格式
输入一行包含一个长度为 的字符串表示 (仅包含数字字符 ),从左至右下标依次为 。
输出格式
输出一行包含一个整数表示答案。
输入 #1
210102输出 #1
8说明/提示
一共有 种不同的方案:
- 所选择的子串下标为 ,反转后的 ;
- 所选择的子串下标为 ,反转后的 ;
- 所选择的子串下标为 ,反转后的 ;
- 所选择的子串下标为 ,反转后的 ;
- 所选择的子串下标为 ,反转后的 ;
- 所选择的子串下标为 ,反转后的 ;
- 所选择的子串下标为 ,反转后的 ;
- 所选择的子串下标为 ,反转后的 。
【评测用例规模与约定】
对于 的评测用例,;
对于 的评测用例,;
对于所有评测用例,。
题解
暴力解:O(n*n*n)超时 理解题意后立刻就想到了一暴力解,左右指针枚举出所有字串使其反转拼接后比较,枚举字串为O(n*n),反转字串也要O(n),时间复杂度是O(n*n*n),超时故有另一解法
区间DP: O(n*n) 状态表示:bool f[N][N]:交换区间[l,r]的第一个和最后一个字符后,是否能使整个字符串的字典序变小
动态规划状态转移: 比较区间左右端点
-
如果
s[l] > s[r]:交换后左小右大,整个字符串一定变小 →f[l][r]=true -
如果
s[l] < s[r]:交换后左大右小,整个字符串一定变大 →f[l][r]=false -
如果
s[l] == s[r]:取决于去掉两端后的内部区间[l+1, r-1]交换后是否能使字符串变小
#include<iostream>#include<cstring>#include<string>using namespace std;const int N = 5e3+10;bool f[N][N]; // f[l][r]表示交换区间[l,r]的第一个和最后一个字符后 // 是否能使整个字符串的字典序变小string s;int ret; // 记录符合条件的区间个数
int main(){ cin>>s; s=" "+s; // 让字符串下标从1开始,方便处理 memset(f,0,sizeof f); // 初始化f数组为false
// len表示区间长度,从2开始(因为至少要两个字符才能交换) for(int len = 2; len < s.size(); len++) { // l表示区间左端点 for(int l = 1; l+len-1 < s.size(); l++) { int r = l+len-1; // 区间右端点
// 如果区间两端字符相等 if(s[l] == s[r]){ // 能否变小取决于去掉两端后的内部区间 f[l][r] = f[l+1][r-1]; if(f[l][r] == true) ret++; // 如果能使字符串变小,计数+1 } // 如果左端字符 > 右端字符 else if(s[l] > s[r]){ f[l][r] = true; // 交换后左小右大,字符串变小 ret++; // 计数+1 } // 如果左端字符 < 右端字符 else if(s[l] < s[r]){ f[l][r] = false; // 交换后字符串变大,不符合条件 // 不计数 } } }
cout<<ret<<endl; return 0;}暴搜分割路径
P4537 矩形
题目描述
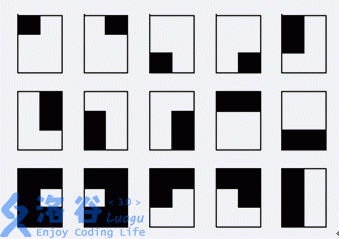
给一个 矩形,由 个单位正方形组成。你需要沿着网格线把它分成非空的两部分,每部分所有格子连通,且至少有一个格子在原矩形的边界上。“连通”是指任两个格子都可以通过水平或者竖直路径连在一起。 求方案总数。例如 的矩形有 种方案。
输入格式
输入仅一行,为两个整数 (,)。
输出格式
输出仅一行,即方案总数。
输入输出样例 #1
输入 #1
3 2输出 #1
15题解
DFS搜索策略
- 从边界内侧的点开始DFS,寻找能到达另一条边界的路径
- 每条这样的路径就是一条有效的分割线
边界条件
if(i < 1 || i >= n || j < 1 || j >= m):到达网格边界- 注意这里判断的是网格点坐标,不是格子坐标
避免重复计数
- 分别从上边界和左边界开始搜索
- 排除角落点,避免重复计算
回溯技巧
st[i][j] = false:在DFS返回前恢复状态- 确保每条路径搜索完毕后不影响其他路径
方向移动
- 四个方向:右(0,1)、左(0,-1)、下(1,0)、上(-1,0)
- 不判断越界是因为边界情况在递归入口统一处理
#include<iostream>using namespace std;const int N = 10; // 最大网格大小int a, b; // 网格范围:0~a 行,0~b 列int dx[10] = {0,0,1,-1}; // 四个方向的行偏移(右、左、下、上)int dy[10] = {1,-1,0,0}; // 四个方向的列偏移
// DFS:从 (i, j) 出发,st 记录已访问的点,返回路径数int dfs(int i, int j, bool (*st)[10]){ int cnt = 0; // 如果到达边界(i==0 或 i==a 或 j==b 或 j==0),返回 1 表示找到一条路径 if (i == 0 || i == a || j == b || j == 0) return 1;
st[i][j] = true; // 标记当前点已访问
for (int w = 0; w < 4; w++) { // 尝试四个方向 i += dx[w]; j += dy[w]; if (!st[i][j]) { // 如果新点未访问,继续 DFS cnt += dfs(i, j, st); } i -= dx[w]; // 回溯 j -= dy[w]; }
st[i][j] = false; // 取消标记(回溯) return cnt;}
int main(){ cin >> a >> b; int cnt = 0; bool st[N][N]; // 访问标记数组
// 第一类起点:上边界 (0, i),i 从 1 到 b-1 for (int i = 1; i < b; i++) { // 清空标记数组 for (int i = 0; i <= a; i++) for (int j = 0; j <= b; j++) st[i][j] = false; st[0][i] = true; // 标记起点已访问 cnt += dfs(1, i, st); // 从 (1, i) 开始 DFS }
// 第二类起点:左边界 (i, 0),i 从 1 到 a-1 for (int i = 1; i < a; i++) { for (int k = 0; k <= a; k++) for (int j = 0; j <= b; j++) st[k][j] = false; st[i][0] = true; // 标记起点已访问 cnt += dfs(i, 1, st); // 从 (i, 1) 开始 DFS }
cout << cnt << endl; // 输出总路径数 return 0;}有向图最小环
P2661信息传递
题目描述
有 个同学(编号为 到 )正在玩一个信息传递的游戏。在游戏里每人都有一个固定的信息传递对象,其中,编号为 的同学的信息传递对象是编号为 的同学。
游戏开始时,每人都只知道自己的生日。之后每一轮中,所有人会同时将自己当前所知的生日信息告诉各自的信息传递对象(注意:可能有人可以从若干人那里获取信息,但是每人只会把信息告诉一个人,即自己的信息传递对象)。当有人从别人口中得知自己的生日时,游戏结束。请问该游戏一共可以进行几轮?
输入格式
输入共 行。
第一行包含 个正整数 ,表示 个人。
第二行包含 个用空格隔开的正整数 ,其中第 个整数 表示编号为 的同学的信息传递对象是编号为 的同学, 且 。
输出格式
共一行一个整数,表示游戏一共可以进行多少轮。
输入输出样例 #1
输入 #1
52 4 2 3 1输出 #1
3说明/提示
样例 1 解释:
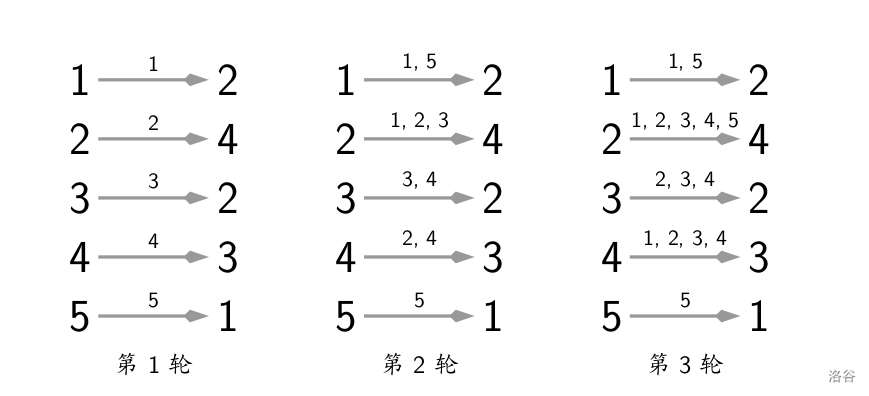
游戏的流程如图所示。当进行完第 轮游戏后, 号玩家会听到 号玩家告诉他自己的生日,所以答案为 。当然,第 轮游戏后, 号玩家、 号玩家都能从自己的消息来源得知自己的生日,同样符合游戏结束的条件。
- 对于 的数据,;
- 对于 的数据,;
- 对于 的数据,。
题解
DFS+拓扑排序 这是一个有向图最小环问题,每个节点只有一个出边,形成多个环或链+环的结构。
核心步骤
1. 拓扑排序去除链部分
- 入度为0的节点肯定不在环中
- 通过不断移除入度为0的节点,最终剩下的就是环
2. DFS统计环大小
- 对每个未被标记的节点(在环中)进行DFS
- 遍历整个环并统计节点数量
- 记录最小的环大小
**关键技巧
- 入度统计:快速找到不在环中的节点
- 拓扑排序:高效去除所有链部分
- DFS遍历:准确统计环的大小
**时间复杂度
- O(n),每个节点最多被访问两次(拓扑排序一次,DFS一次)
代码
#include <iostream>#include <queue>using namespace std;
const int N = 2e5 + 10;int n;int ne[N]; // 存储每个节点指向的下一个节点int in[N]; // 存储每个节点的入度bool st[N]; // 标记数组,用于标记节点是否被访问过或是否在环外int cnt; // 用于统计环的大小
// DFS函数:遍历环并统计环的大小void dfs(int a){ cnt++; // 环的大小加1 st[a] = true; // 标记当前节点已访问 int b = ne[a]; // 获取当前节点指向的下一个节点 if(!st[b]) dfs(b); // 如果下一个节点未被访问,继续DFS}
int main(){ cin >> n;
// 读取每个节点指向的下一个节点,并计算入度 for(int i = 1; i <= n; i++) { cin >> ne[i]; // i -> ne[i],所以ne[i]的入度加1 in[ne[i]]++; }
// 1. 利用拓扑排序给环以外的点打上标记 queue<int> q; // 将所有入度为0的节点(不在环中的起点)加入队列 for(int i = 1; i <= n; i++) { if(in[i] == 0) q.push(i); }
// 拓扑排序过程:移除所有不在环中的节点 while(q.size()) { auto a = q.front(); q.pop(); st[a] = true; // 标记该节点不在环中
int b = ne[a]; // a -> b in[b]--; // b的入度减1
// 如果b的入度变为0,说明b也不在环中,加入队列 if(in[b] == 0) q.push(b); }
// 2. 利用DFS计算最小环的大小 int ret = n; // 初始化最小环大小为n(最大可能值)
// 遍历所有节点,寻找环 for(int i = 1; i <= n; i++) { // 如果节点i未被标记(说明在环中)且未被访问过 if(!st[i]) { cnt = 0; // 重置计数器 dfs(i); // 遍历该环 ret = min(ret, cnt); // 更新最小环大小 } }
cout << ret << endl; return 0;}拓扑排序+dp/最短路算法求最长路
P1807 最长路
题目描述
设 为有 个顶点的带权有向无环图, 中各顶点的编号为 到 ,请设计算法,计算图 中 间的最长路径。
输入格式
输入的第一行有两个整数,分别代表图的点数 和边数 第 到第 行,每行 个整数 u<vuvw$ 的边。
输出格式
输出一行一个整数,代表 到 的最长路。 若 无法到达 ,请输出 。
输入输出样例 #1
输入 #1
2 11 2 1输出 #1
1说明/提示
【数据规模与约定】
- 对于 的数据,,。
- 对于 的数据,,。
- 对于 的数据,,,,。
题解
解法1:拓扑排序+动态规划
-
在本题中有个重要的条件,对于任意⼀条边 u->v,u 都是⼩于 v 的。因此,1 绝对是⼊度为 0 的点,n绝对是出度为 0 的点。并且图中没有环形结构,是⼀个拓扑图。在拓扑图中,可以看做 1 为起点,n 为终点。那么就可以利⽤拓扑排序的过程,更新出最⻓路。
-
细节问题:有可能存在别的⼊度为 0 的点,需要提前处理掉。
-
动态规划的逻辑:
- 状态表⽰: f[i] 表⽰从 1 ⾛到 i 位置的最⻓路。
- 状态转移⽅程: f[i] = max(f[prev] + w) ,其中 prev 为 i 结点的前驱结点,w 为 i->prev 的权值。
#include <iostream>#include <queue>#include <vector>#include <cstring>using namespace std;
typedef pair<int, int> PII; // 存储边的终点和权重const int N = 1510;int n, m;vector<PII> edges[N]; // 邻接表存储图int in[N]; // 存储每个节点的入度int f[N]; // 存储从节点1到每个节点的最长路径
int main(){ cin >> n >> m; // 读入图数据,构建邻接表 for(int i = 1; i <= m; i++) { int u, v, w; cin >> u >> v >> w; edges[u].push_back({v, w}); in[v]++; // 终点v的入度加1 }
queue<int> q; // 先处理入度为0,但不是1号结点的结点(这些节点无法从1到达) for(int i = 2; i <= n; i++) { if(in[i] == 0) q.push(i); f[i] = -1e9; // 初始化为一个很小的值,表示不可达 }
// 拓扑排序预处理:移除那些无法从节点1到达的节点形成的环 while(q.size()) { auto u = q.front(); q.pop(); for(auto& t : edges[u]) { int v = t.first; in[v]--; // 减少后继节点的入度 if(in[v] == 0) q.push(v); // 如果入度变为0,加入队列 } }
// 现在处理从节点1开始的路径 q.push(1); while(q.size()) { auto u = q.front(); q.pop(); for(auto& t : edges[u]) { int v = t.first, w = t.second; // 更新到节点v的最长路径 f[v] = max(f[v], f[u] + w); in[v]--; // 减少入度,模拟拓扑排序 if(in[v] == 0) q.push(v); // 如果入度变为0,加入队列 } }
// 输出结果 //注意memset初始化数组不可为-0x3f3f3f3f,因为实际存到数组里的数和-0x3f3f3f3f不相等 if(f[n] == -1E9) // 如果节点n不可达 cout << -1 << endl; else cout << f[n] << endl; // 输出从1到n的最长路径
return 0;}解法2:转换为最短路。
- 问题转化:当所有边的权值改成相反数。那么最⻓路问题就变成了最短路问题,找出最短路之后,输出相反数即可。注意:这种⽅法是万能的,但是如果数据范围过⼤时,时间复杂度接受不了。
解法三:SPFA转换成为最长路
#include<iostream>#include<vector>#include<queue>#include<cstring>using namespace std;
const int N = 1600, M = 5E4 + 10;typedef pair<int, int>PII;int n, m;vector<PII>ve[M]; // 邻接表存储图,ve[u]存储从u出发的所有边(终点, 权重)int dist[N]; // 存储从起点1到每个节点的最长距离bool st[N]; // 标记节点是否在队列中
void spfa(){ queue<int>q; dist[1] = 0; // 起点到自身的距离为0 q.push(1); // 起点入队 st[1] = true; // 标记起点在队列中
while (q.size()) // 队列不为空时循环 { int u = q.front(); q.pop(); // 取出队首节点 st[u] = false; // 标记该节点已出队
// 遍历u的所有邻接边 for (auto p : ve[u]) { int v = p.first, w = p.second; // v是邻接点,w是边权重
// 如果通过u到v的路径比当前已知到v的路径更长,则更新 if (dist[u] + w > dist[v]) { dist[v] = dist[u] + w; // 更新到v的最长距离
// 如果v不在队列中,则加入队列 if (st[v] == false) { q.push(v); st[v] = true; } } } }
// 输出结果:如果终点n不可达则输出-1,否则输出最长距离 if (dist[n] == -1e9)cout << "-1" << endl; else cout << dist[n] << endl;}
int main(){ cin >> n >> m; // 输入节点数n和边数m
// 读入所有边信息,构建邻接表 while (m--) { int u, v, w; cin >> u >> v >> w; ve[u].push_back({ v,w }); // 添加有向边 u->v,权重为w }
// 初始化所有节点到起点的距离为负无穷(表示初始时不可达) for (int i = 1; i <= n; i++)dist[i] = -1e9;
spfa(); // 调用SPFA算法求最长路径
return 0;}二分+差分
P1083 借教室
题目描述
在大学期间,经常需要租借教室。大到院系举办活动,小到学习小组自习讨论,都需要向学校申请借教室。教室的大小功能不同,借教室人的身份不同,借教室的手续也不一样。 面对海量租借教室的信息,我们自然希望编程解决这个问题。
我们需要处理接下来 天的借教室信息,其中第 天学校有 个教室可供租借。共有 份订单,每份订单用三个正整数描述,分别为 ,表示某租借者需要从第 天到第 天租借教室(包括第 天和第 天),每天需要租借 个教室。
我们假定,租借者对教室的大小、地点没有要求。即对于每份订单,我们只需要每天提供 个教室,而它们具体是哪些教室,每天是否是相同的教室则不用考虑。
借教室的原则是先到先得,也就是说我们要按照订单的先后顺序依次为每份订单分配教室。如果在分配的过程中遇到一份订单无法完全满足,则需要停止教室的分配,通知当前申请人修改订单。这里的无法满足指从第 天到第 天中有至少一天剩余的教室数量不足 个。
现在我们需要知道,是否会有订单无法完全满足。如果有,需要通知哪一个申请人修改订单。
输入格式
第一行包含两个正整数 ,表示天数和订单的数量。
第二行包含 个正整数,其中第 个数为 ,表示第 天可用于租借的教室数量。
接下来有 行,每行包含三个正整数 ,表示租借的数量,租借开始、结束分别在第几天。
每行相邻的两个数之间均用一个空格隔开。天数与订单均用从 开始的整数编号。
输出格式
如果所有订单均可满足,则输出只有一行,包含一个整数 。
否则(订单无法完全满足)输出两行,第一行输出一个负整数 ,第二行输出需要修改订单的申请人编号。
输入输出样例 #1
输入 #1
4 32 5 4 32 1 33 2 44 2 4输出 #1
-12说明/提示
【输入输出样例说明】
第 份订单满足后, 天剩余的教室数分别为 。第 份订单要求第 天到第 天每天提供 个教室,而第 天剩余的教室数为 ,因此无法满足。分配停止,通知第 个申请人修改订单。
【数据范围】
对于 的数据,有 ;
对于 的数据,有 ;
对于 的数据,有 ;
对于 的数据,有 ,,。
NOIP 2012 提高组 第二天 第二题
2022.2.20 新增一组 hack 数据
题解
⼒破万法:线段树。但是杀鸡焉⽤宰⽜⼑,可以⽤更简单的做法(其实是因为我们还没学…)。 设⽆法完成的订单的天数为 ret 。针对某⼀天 x ,根据题意可得:
- 当 x ≥ ret 时,处理完 [1, x] 天的订单,⼀定⽆法完成;
- 当 x < ret 时,处理完 [1, x] 天的订单,⼀定可以完成。
在解空间中,根据 的位置,可以将解集分成两部分,具有「⼆段性」,那么我们就可以「⼆分答案」。
接下来的问题就是给定⼀个天数 x ,如何判断能否完成 [1, x] 天内的所有订单: 利⽤「差分」数组 处理完 [1, x] 区间的修改,还原「原数组」之后判断是否「全部 ≥ 0 」即可。 时间复杂度: O(n log n) 。
#include <iostream>using namespace std;
const int N = 1e6 + 10; // 定义最大数据范围int n, m; // n-天数,m-订单数int r[N]; // 每天可用的教室数量int d[N], s[N], t[N]; // 订单信息:d-每天用量,s-开始日,t-结束日int f[N]; // 差分数组
// 检查处理前x个订单是否可行bool check(int x){ // 初始化差分数组,表示每天剩余的教室数量 for(int i = 1; i <= n; i++) { f[i] = r[i] - r[i - 1]; // 构建差分数组 }
// 处理前x个订单 for(int i = 1; i <= x; i++) { // 在差分数组上应用订单:从s[i]到t[i]每天减少d[i]个教室 f[s[i]] -= d[i]; // 开始位置减去需求量 f[t[i] + 1] += d[i]; // 结束位置的下一天加回需求量 }
// 通过前缀和还原实际的每天剩余教室数量 for(int i = 1; i <= n; i++) { f[i] = f[i - 1] + f[i]; // 计算前缀和,得到每天实际剩余教室 if(f[i] < 0) return false; // 如果某天教室不足,返回false } return true; // 所有订单都能满足,返回true}
int main(){ cin >> n >> m; // 输入天数和订单数
// 输入每天可用的教室数量 for(int i = 1; i <= n; i++) cin >> r[i];
// 输入订单信息 for(int i = 1; i <= m; i++) cin >> d[i] >> s[i] >> t[i];
// 二分查找:找到第一个无法满足的订单 int l = 1, r = m; // 搜索范围:从第1个订单到第m个订单 while(l < r) { int mid = (l + r) / 2; // 取中间点 if(check(mid)) l = mid + 1; // 前mid个订单可行,检查更大的范围 else r = mid; // 前mid个订单不可行,检查更小的范围 }
// 输出结果 if(check(l)) cout << 0 << endl; // 所有订单都能满足 else cout << -1 << endl << l << endl; // 输出-1和第一个无法满足的订单编号
return 0;}思考:在解题时如何想到二分
当想要枚举数据时发现时间太长,并且答案是区间某一个确定值;可以试着分析题目条件是否具有二段性
// 典型的问题描述:// - 找到最大的x使得条件满足// - 找到最小的x使得条件满足// - 第一个不满足条件的点// - 最后一个满足条件的点二分答案
P1843 奶牛晒衣服
题目背景
熊大妈决定给每个牛宝宝都穿上可爱的婴儿装 。但是由于衣服很湿,为牛宝宝晒衣服就成了很不爽的事情。于是,熊大妈请你(奶牛)帮助她完成这个重任。
题目描述
一件衣服在自然条件下用一秒的时间可以晒干 点湿度。抠门的熊大妈只买了一台烘衣机 。使用用一秒烘衣机可以让一件衣服额外烘干 点湿度(一秒晒干 湿度),但在同一时间内只能烘一件衣服。现在有 件衣服,第 衣服的湿度为 (保证互不相同),要你求出弄干所有衣服的最少时间(湿度为 为干 )。
输入格式
第一行三个整数,分别为 。 接下来 到 行,第 行输入 。
输出格式
一行,弄干所有衣服的最少时间。
输入输出样例 #1
输入 #1
3 2 1123输出 #1
1说明/提示
样例解释
让机器烘第三件衣服即可一秒完成。
数据范围
题解
错误解
第一眼直接贪心
- 每次都烘最湿的衣服
- 优先处理湿度大的衣服
n=3, a=1, b=2湿度:[3, 3, 3]如果每次都烘最湿的,可能需要2秒。但最优解是1秒内烘任意一件,自然晾干其他的。
从”过程思维”到”结果思维”
- 贪心:关注每一步该做什么(过程)
- 二分答案:先假设知道答案,再验证(结果) 二分关注全局可行性(给定总时间,判断能否完成任务)
正解
思路
- 问题问的是”最少时间” → 可能二分
- 时间具有单调性:
- 如果x分钟能烘干所有衣服,那么x+1分钟肯定也能
- 如果x分钟不能烘干,那么x-1分钟肯定也不能
设经过的时间是 x 。根据题意,我们可以发现如下性质:
- 经过的时间如果是 x 的话,烘⼲机的「使⽤次数」最多也是 x ;
- 当 x 在「增⼤」的时候,能弄⼲的⾐服在「增多」;
- 当 x 在「减⼩」的时候,能弄⼲的⾐服也在「减少」。那么在整个「解空间」⾥⾯,设弄⼲所有⾐服的最少时间是 ret ,于是有:
- 当 x ≥ ret 时,我们「能弄⼲」所有⾐服;
- 当 x < ret 时,我们「不能弄⼲」所有⾐服。
在解空间中,根据 ret的位置,可以将解集分成两部分,具有「⼆段性」,那么我们就可以「⼆分答 案」。 接下来的重点就是,给定⼀个时间x ,判断「是否能把所有的⾐服全部弄⼲」。当时间为x时,所 有⾐服能够⾃然蒸发a* x 的湿度,于是:
- 如果 w[i] ≤ a ⋅ x :让它⾃然蒸发;
- 如果 w[i] > a ⋅ x:需要⽤烘⼲机烘⼲ t = w[i] − a ⋅ x的湿度,次数为 t / b + (t % b == 0 ? 0 : 1) 那么我们可以遍历所有的⾐服,计算烘⼲机的「使⽤次数」:
- 如果使⽤次数「⼤于」给定的时间 x ,说明不能全部弄⼲;
- 如果使⽤次数「⼩于等于」给定的时间 x ,说明能全部弄⼲。
#include <iostream>using namespace std;typedef long long LL; // 定义长整型别名,防止数据溢出const int N = 5e5 + 10; // 定义数组最大大小
LL n, a, b; // n-衣服数量,a-自然晾干速度,b-烘干机额外速度LL w[N]; // 存储每件衣服的湿度
// 检查在x秒内是否能烘干所有衣服bool check(LL x){ LL cnt = 0; // 需要烘干机工作的总时间(秒)
for(int i = 1; i <= n; i++) { // 如果自然晾干就能满足,跳过 if(w[i] <= a * x) continue;
// 计算需要烘干机补足的湿度 LL d = w[i] - a * x;
// 计算这件衣服需要烘干机工作的时间 // 向上取整:d/b 如果有余数就多需要1秒 cnt = cnt + d / b + (d % b == 0 ? 0 : 1);
// 注意:这里应该提前判断,如果cnt已经超过x,可以直接返回false优化性能 // if(cnt > x) return false; }
// 总烘干机时间不超过x秒(因为只有一台机器) return cnt <= x;}
int main(){ // 输入数据 cin >> n >> a >> b; for(int i = 1; i <= n; i++) cin >> w[i];
// 二分查找最小时间 LL l = 1, r = 5e5; // 时间范围:1秒到最大可能时间
while(l < r) { LL mid = (l + r) / 2; // 取中间时间
if(check(mid)) r = mid; // mid秒可行,尝试更小的时间 else l = mid + 1; // mid秒不可行,需要更多时间 }
// 输出最小可行时间 cout << l << endl;
return 0;}P3853 路标设置
题目背景
B 市和 T 市之间有一条长长的高速公路,这条公路的某些地方设有路标,但是大家都感觉路标设得太少了,相邻两个路标之间往往隔着相当长的一段距离。为了便于研究这个问题,我们把公路上相邻路标的最大距离定义为该公路的“空旷指数”。
题目描述
现在政府决定在公路上增设一些路标,使得公路的“空旷指数”最小。他们请求你设计一个程序计算能达到的最小值是多少。请注意,公路的起点和终点保证已设有路标,公路的长度为整数,并且原有路标和新设路标都必须距起点整数个单位距离。
输入格式
第 行包括三个数 ,分别表示公路的长度,原有路标的数量,以及最多可增设的路标数量。
第 行包括递增排列的 个整数,分别表示原有的 个路标的位置。路标的位置用距起点的距离表示,且一定位于区间 内。
输出格式
输出 行,包含一个整数,表示增设路标后能达到的最小“空旷指数”值。
输入 #1
101 2 10 101输出 #1
51说明/提示
公路原来只在起点和终点处有两个路标,现在允许新增一个路标,应该把新路标设在距起点 或 个单位距离处,这样能达到最小的空旷指数 。
的数据中,,。
的数据中,, 。
的数据中,。
题解
二分答案 ⼆段性:设最优解为 ret :
- 如果 x >= ret ,需要设置路标的数量就⼩于等于 k ;
- 如果 x < ret ,需要设置路标的数量就⼤于 k 。 对于⼀个数 x ,如何判断设置路标的数量:
- 设 d = a[i] - a[i - 1] ,那么需要路标的数量就是 d / x ;
- 如果 d % x == 0 ,此时就可以少⽤⼀个路标。
#include <iostream>using namespace std;
const int N = 1e5 + 10; // 定义最大数组大小
int len, n, k; // len:公路长度, n:原有路标数量, k:最多可增设路标数量int a[N]; // 存储原有路标位置
// 检查函数:判断当最大间隔为x时,需要增设的路标数量是否不超过kbool check(int x){ int cnt = 0; // 记录需要增设的路标数量
// 遍历所有相邻的原有路标 for(int i = 2; i <= n; i++) { int d = a[i] - a[i - 1]; // 计算相邻路标间的距离
cnt += d / x; // 在距离d中,每x长度需要增设一个路标
// 如果距离正好能被x整除,最后一个间隔不需要增设路标 if(d % x == 0) cnt--; }
// 判断需要增设的路标数量是否在允许范围内 return cnt <= k;}
int main(){ // 输入公路长度、原有路标数量、最多可增设路标数量 cin >> len >> n >> k;
// 输入原有路标的位置(按递增顺序排列) for(int i = 1; i <= n; i++) cin >> a[i];
// 二分查找最小空旷指数 int l = 1, r = len; // 最小可能间隔为1,最大可能间隔为公路全长
while(l < r) { int mid = (l + r) / 2; // 取中间值作为候选的最大间隔
if(check(mid)) r = mid; // 如果mid可行,尝试更小的间隔(往左搜索) else l = mid + 1; // 如果mid不可行,需要更大的间隔(往右搜索) }
// 输出最小的可能空旷指数 cout << l << endl;
return 0;}正负抵消+前缀和+哈希表(平衡计数问题)
P1114 “非常男女”计划
题目描述
近来,初一年的 XXX 小朋友致力于研究班上同学的配对问题(别想太多,仅是舞伴),通过各种推理和实验,他掌握了大量的实战经验。例如,据他观察,身高相近的人似乎比较合得来。
万圣节来临之际,XXX 准备在学校策划一次大型的 “非常男女” 配对活动。对于这次活动的参与者,XXX 有自己独特的选择方式。他希望能选择男女人数相等且身高都很接近的一些人。这种选择方式实现起来很简单。他让学校的所有人按照身高排成一排,然后从中选出连续的若干个人,使得这些人中男女人数相等。为了使活动更热闹,XXX 当然希望他能选出的人越多越好。请编写程序告诉他,他最多可以选出多少人来。
输入格式
第一行有一个正整数 ,代表学校的人数。 第二行有 个用空格隔开的数,这些数只能是 或 ,其中, 代表是一个女生, 代表是一个男生。
输出格式
输出一个非负整数。这个数表示在输入数据中最长的一段男女人数相等的子区间的长度。 如果不存在男女人数相等的子区间,请输出 。
输入输出样例 #1
输入 #1
90 1 0 0 0 1 1 0 0输出 #1
6解法
- 看到的第一眼想到了,子区间之和为子区间长度的一半时,该区间是和为0的区间,两层for循环枚举区间长度和左端点,更新最长子区间;但如此会发现时间复杂度会很高,因此应该转换成下面一解法来优化
-
数值转换:将0转为-1,1保持为1
- 这样当0和1数量相等时,区间和就为0
-
前缀和原理:
- 如果
sum[i] == sum[j]((1,i)区间和 ==(1,j)区间和),说明区间[i+1, j]的和为0 - 因为
sum[j] - sum[i] = 0
- 如果
-
哈希表作用:
mp[sum]记录前缀和sum第一次出现的位置- 当同样的前缀和再次出现时,说明找到了一个0和1数量相等的区间
// 数值反转+前缀和+哈希// 思路:将0视为-1,1视为1,计算前缀和// 如果sum[i] == sum[j],说明区间[i+1, j]的和为0(0和1数量相等)// 使用哈希表记录每个前缀和第一次出现的位置
#include<iostream>#include<unordered_map>using namespace std;
int main(){ int n; cin >> n; int ret = 0; // 记录最长子数组长度 int sum = 0; // 当前前缀和 unordered_map<int, int> mp; // 存储<前缀和, 第一次出现的位置>
// 关键:初始化前缀和为0的位置为0 // 表示在数组开始前,前缀和就是0(相当于空数组) mp[0] = 0;
for (int i = 1; i <= n; i++) { int x; cin >> x; // 数值反转:0变成-1,1保持1 // 这样当0和1数量相等时,区间和就为0 x = (x == 0 ? -1 : 1); sum += x; // 更新前缀和
// 如果当前前缀和之前出现过 if (mp.count(sum)) { // 计算当前区间长度:i - mp[sum] // mp[sum]是前缀和sum第一次出现的位置 // 当前区间 [mp[sum]+1, i] 的和为0 ret = max(ret, i - mp[sum]); } else { // 如果这个前缀和是第一次出现,记录它的位置 mp[sum] = i; } } cout << ret << endl; return 0;}P1147 连续自然数和
题目描述
对一个给定的正整数 ,求出所有的连续的正整数段(每一段至少有两个数),这些连续的自然数段中的全部数之和为 。
例子:,所以从 到 的一个自然数段为 的一个解。
输入格式
包含一个整数的单独一行给出 的值()。
输出格式
每行两个正整数,给出一个满足条件的连续正整数段中的第一个数和最后一个数,两数之间用一个空格隔开,所有输出行的第一个按从小到大的升序排列,对于给定的输入数据,保证至少有一个解。
输入输出样例 #1
输入 #1
10000输出 #1
18 142297 328388 4121998 2002题解
- 发现可以暴力n* n直接遍历,但是会超时
- 利用前缀和+哈希表;这两的组合拳啊;
- 从前往后遍历每⼀个数,对于当前的前缀和 sum[i] ,仅需在前⾯找到前缀和为 sum[i] - m 位置 p 。如果存在, 则 [p + 1, i] 就是要找的⼀个区间。
- 这也是维护平衡,平衡的值为n;
- 大区间-右区间=维护的左区间
- 因此复杂度转化为n
#include <iostream>#include <unordered_map>using namespace std;
typedef long long LL;int m;unordered_map<LL, int> mp; // 存储前缀和及其对应的位置
int main(){ cin >> m; // 输入目标值m
int n = (m + 1) / 2; // 最大可能的区间右端点 // 因为1+2+...+n = n(n+1)/2 >= m 时,n的最小值约为√(2m) // 这里简化处理,取(m+1)/2作为上限
mp[0] = 0; // 初始化:前缀和为0时对应的位置是0 LL sum = 0; // 当前前缀和
for(int i = 1; i <= n; i++) { sum += i; // 计算从1到i的累加和
// 关键思路:如果存在 sum - (sum - m) = m // 即当前前缀和sum减去之前某个前缀和等于m // 那么这两个位置之间的连续整数和就是m if(mp.count(sum - m)) { // 输出区间:从 mp[sum-m]+1 到 i // 因为mp[sum-m]记录的是前缀和为sum-m时的右端点位置 cout << mp[sum - m] + 1 << " " << i << endl; }
mp[sum] = i; // 记录当前前缀和对应的位置 }
return 0;}P3131 Subsequences Summing to Sevens S
题目描述
Farmer John 的 头奶牛站成一排,这是它们时不时会做的事情。每头奶牛都有一个独特的整数 ID 编号,以便 Farmer John 能够区分它们。Farmer John 希望为一组连续的奶牛拍照,但由于童年时与数字 相关的创伤事件,他只希望拍摄一组奶牛,如果它们的 ID 加起来是 7 的倍数。
请帮助 Farmer John 确定他可以拍摄的最大奶牛组的大小。
输入格式
输入的第一行包含 ()。接下来的 行每行包含一头奶牛的整数 ID(所有 ID 都在 范围内)。
输出格式
请输出 ID 之和为 7 的倍数的最大连续奶牛组中的奶牛数量。如果不存在这样的组,则输出 0。
输入 #1
7351621410输出 #1
5说明/提示
在这个例子中,。
题解
**前缀和+同余+哈希(这里用的是思想,但也可map)
-
如果
( f[right] - f[left-1] )%7 ==0;那么代表[ left+1,right ]区间符合,我们可以拆开表达式有f[ right ]%7==f[left-1]%7;如果满足这个表达式就是正解,因为区间要长故left要更靠左 -
对于前缀和 f[i] ,仅需找到 [1, i - 1] 区间内,前缀和模 7 等于 f[i] % 7 的最左位置j
**思路
- 初始化:
id[0] = 0:表示前缀和为0(模7)在第0天就出现了- 这样如果前k天的和是7的倍数,区间长度就是
k - 0 = k
- 遍历每一天:
- 计算当前前缀和模7的结果
- 如果这个余数之前出现过:
- 从上次出现的位置到现在的位置,这段区间的和模7为0
- 更新最大区间长度
- 如果这个余数第一次出现:
- 记录当前位置
#include <iostream>#include <cstring>using namespace std;
const int N = 10; // 因为要对7取模,所以只需要大小为7的数组,N取10足够int n; // 输入的天数int id[N]; // 记录每个余数第一次出现的位置(天数)
int main(){ cin >> n; // 读入天数
// 初始化id数组为-1,表示该余数还没有出现过 memset(id, -1, sizeof id);
// 关键初始化:余数为0时,应该在第0天就出现了 // 这样可以处理从第一天开始就满足条件的情况 id[0] = 0; // 前缀和为7的倍数的情况从第0天开始计算
int sum = 0, ret = 0; // sum: 当前前缀和对7取模的结果 // ret: 保存最长连续天数的结果
for(int i = 1; i <= n; i++) // 从第1天开始遍历 { int x; cin >> x; // 读入第i天的降雨量
// 计算前缀和模7的结果 sum = (sum + x) % 7;
// 如果这个余数之前出现过,说明从上次出现到现在的区间和是7的倍数 if(id[sum] != -1) // 计算这段区间的长度,并更新最大值 ret = max(ret, i - id[sum]); else // 如果这个余数第一次出现,记录它的位置 id[sum] = i; }
cout << ret << endl; // 输出最长连续天数 return 0;}归并排序-合并有序数组
P1309 瑞士轮
题目背景
在双人对决的竞技性比赛,如乒乓球、羽毛球、国际象棋中,最常见的赛制是淘汰赛和循环赛。前者的特点是比赛场数少,每场都紧张刺激,但偶然性较高。后者的特点是较为公平,偶然性较低,但比赛过程往往十分冗长。
本题中介绍的瑞士轮赛制,因最早使用于 1895 年在瑞士举办的国际象棋比赛而得名。它可以看作是淘汰赛与循环赛的折中,既保证了比赛的稳定性,又能使赛程不至于过长。
题目描述
名编号为 的选手共进行 轮比赛。每轮比赛开始前,以及所有比赛结束后,都会按照总分从高到低对选手进行一次排名。选手的总分为第一轮开始前的初始分数加上已参加过的所有比赛的得分和。总分相同的,约定编号较小的选手排名靠前。
每轮比赛的对阵安排与该轮比赛开始前的排名有关:第 名和第 名、第 名和第 名、……、第 名和第 名、…… 、第 名和第 名,各进行一场比赛。每场比赛胜者得 分,负者得 分。也就是说除了首轮以外,其它轮比赛的安排均不能事先确定,而是要取决于选手在之前比赛中的表现。
现给定每个选手的初始分数及其实力值,试计算在 轮比赛过后,排名第 的选手编号是多少。我们假设选手的实力值两两不同,且每场比赛中实力值较高的总能获胜。
输入格式
第一行是三个正整数 ,每两个数之间用一个空格隔开,表示有 名选手、 轮比赛,以及我们关心的名次 。
第二行是 个非负整数 ,每两个数之间用一个空格隔开,其中 表示编号为 的选手的初始分数。
第三行是 个正整数 ,每两个数之间用一个空格隔开,其中 表示编号为 的选手的实力值。
输出格式
一个整数,即 轮比赛结束后,排名第 的选手的编号。
输入输出样例 #1
输入 #1
2 4 27 6 6 710 5 20 15输出 #1
1说明/提示
【样例解释】
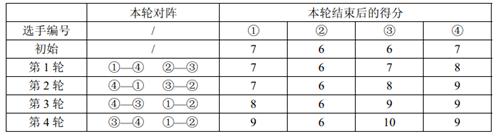
【数据范围】
对于 的数据,;
对于 的数据,;
对于 的数据,。
noip2011 普及组第 3 题。
题解
- 看到题目思考片刻后发现是模拟题;先想到了每轮更新结果后用sort排序 时间复杂度为:nlogn m+nm*;(排序和比赛分别执行m次)
- 此时发现有超时风险因此想到归并排序
- 前后两两⽐较的过程中,如果把获胜的⼈放在⼀组,失败的⼈放在⼀组,那么这两组⼈的⽐分也是从⼤到⼩排序。因此,可以在模拟的过程中,将每次⽐试的结果放在两个数组中,然后合并两个有序数组即可。
- 时间复杂度应该是nlogn+nm;(初始化排序+合并m次有序数组) 整个过程就类似于归并排序。
#include <iostream>#include <algorithm>using namespace std;
const int N = 2e5 + 10; // 定义最大数据范围int n, r, q; // n:每组人数, r:轮数, q:查询的排名
struct node{ int s, id, w; // s:分数, id:选手编号, w:实力值}a[N];
node x[N], y[N]; // x:胜利组, y:失败组
// 排序比较函数:先按分数降序,分数相同按编号升序bool cmp(node& x, node& y){ if(x.s == y.s) return x.id < y.id; return x.s > y.s;}
// 合并两个有序数组(胜利组和失败组)void merge(){ // 合并两个有序数组 int cur1 = 1, cur2 = 1, i = 1; // cur1:胜利组指针, cur2:失败组指针, i:结果数组指针
// 双指针合并 while(cur1 <= n && cur2 <= n) { // 比较规则:分数高的优先,分数相同时编号小的优先 if(x[cur1].s > y[cur2].s || (x[cur1].s == y[cur2].s && x[cur1].id < y[cur2].id)) { a[i++] = x[cur1++]; // 胜利组的当前元素更优 } else { a[i++] = y[cur2++]; // 失败组的当前元素更优 } }
// 处理剩余元素 while(cur1 <= n) a[i++] = x[cur1++]; // 胜利组还有剩余 while(cur2 <= n) a[i++] = y[cur2++]; // 失败组还有剩余}
int main(){ cin >> n >> r >> q; // 输入每组人数、轮数、查询排名
// 输入初始分数 for(int i = 1; i <= n + n; i++) { cin >> a[i].s; a[i].id = i; // 记录选手编号 }
// 输入实力值 for(int i = 1; i <= n + n; i++) { cin >> a[i].w; }
// 初始排序 sort(a + 1, a + 1 + n + n, cmp);
// 进行r轮比赛 while(r--) { int pos = 1; // 分组位置指针
// 每轮比赛:相邻两人一组进行比赛 for(int i = 1; i <= n + n; i += 2) { if(a[i].w > a[i + 1].w) // 前一个选手实力更强 { a[i].s++; // 获胜者分数+1 x[pos] = a[i]; // 进入胜利组 y[pos] = a[i + 1]; // 进入失败组 } else // 后一个选手实力更强或平局 { a[i + 1].s++; // 获胜者分数+1 x[pos] = a[i + 1]; // 进入胜利组 y[pos] = a[i]; // 进入失败组 } pos++; }
// 合并胜利组和失败组,保持整体有序 merge(); }
// 输出第q名选手的编号 cout << a[q].id << endl;
return 0;}分割枚举+排序
P1158 导弹拦截
题目描述
经过 年的韬光养晦,某国研发出了一种新的导弹拦截系统,凡是与它的距离不超过其工作半径的导弹都能够被它成功拦截。当工作半径为 时,则能够拦截与它位置恰好相同的导弹。但该导弹拦截系统也存在这样的缺陷:每套系统每天只能设定一次工作半径。而当天的使用代价,就是所有系统工作半径的平方和。
某天,雷达捕捉到敌国的导弹来袭。由于该系统尚处于试验阶段,所以只有两套系统投入工作。如果现在的要求是拦截所有的导弹,请计算这一天的最小使用代价。
输入格式
第一行包含 个整数 ,每两个整数之间用一个空格隔开,表示这两套导弹拦截系统的坐标分别为 。第二行包含 个整数 ,表示有 颗导弹。接下来 行,每行两个整数 ,中间用一个空格隔开,表示一颗导弹的坐标 。不同导弹的坐标可能相同。
输出格式
一个整数,即当天的最小使用代价。
输入 #1
0 0 10 02-3 310 0输出 #1
18输入 #2
0 0 6 05-4 -2-2 34 06 -29 1输出 #2
30说明/提示
两个点 之间距离的平方是 。
两套系统工作半径 的平方和,是指 分别取平方后再求和,即 。
样例 1 说明
样例 中要拦截所有导弹,在满足最小使用代价的前提下,两套系统工作半径的平方分别为 和 。
样例 2 说明
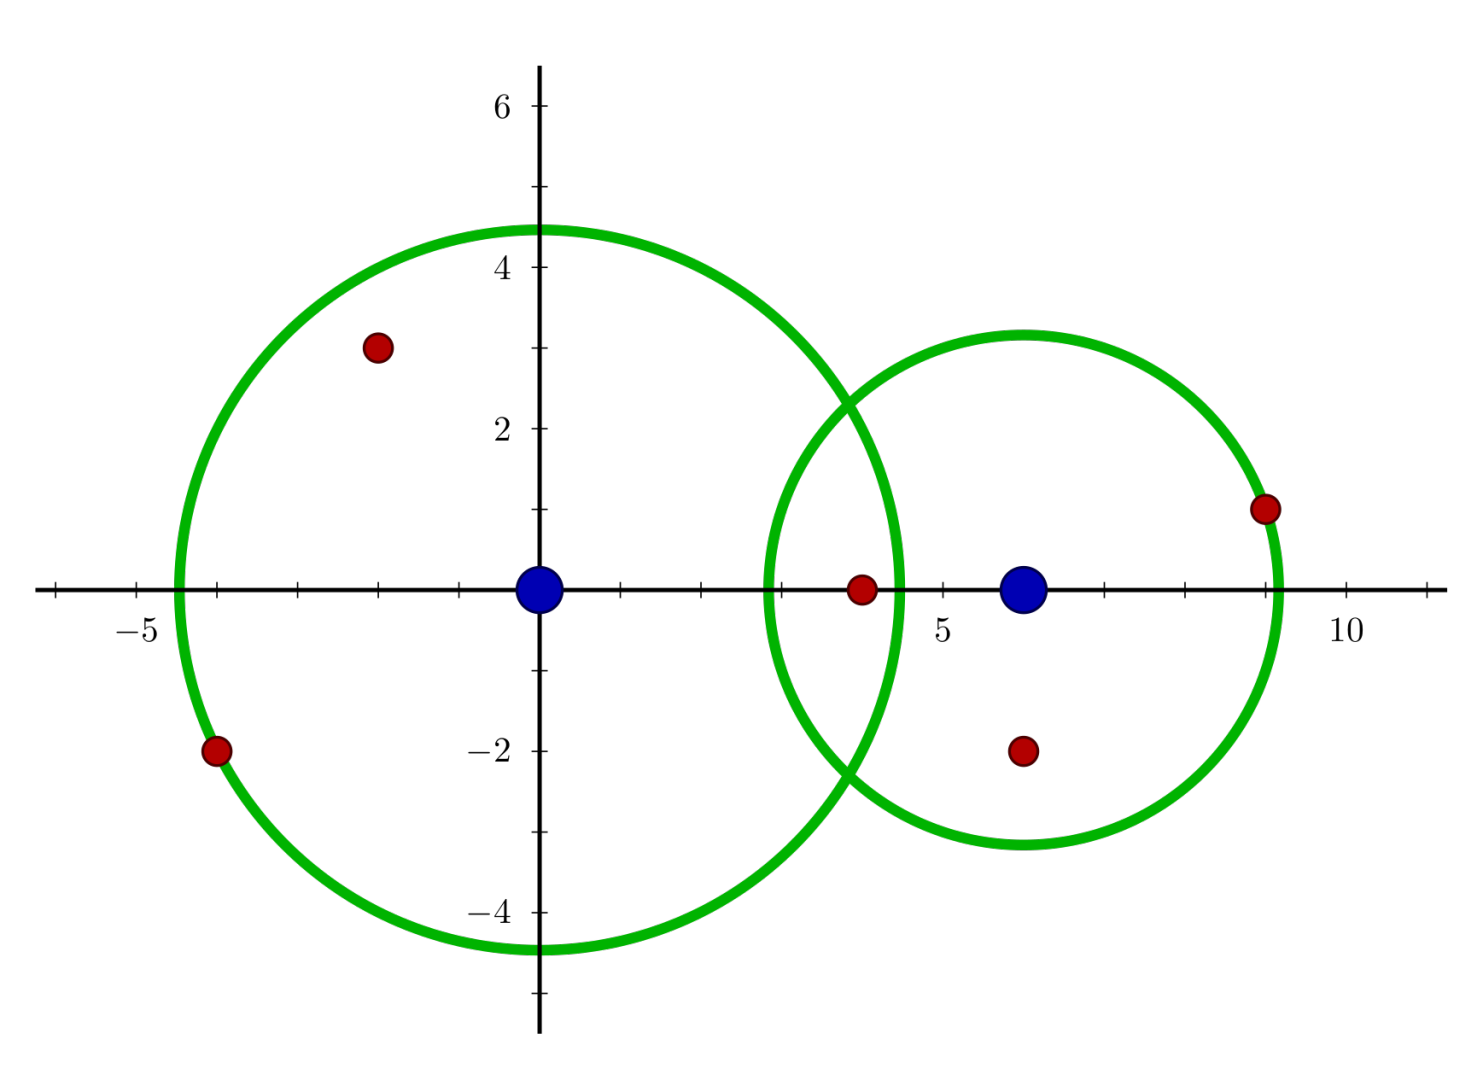
样例 中的导弹拦截系统和导弹所在的位置如下图所示。要拦截所有导弹,在满足最小使用代价的前提下,两套系统工作半径的平方分别为 和 。
【数据范围】。
- 对于 的数据,。
- 对于 的数据,。
- 对于 的数据,。
- 对于 的数据,。
- 对于 的数据,,且所有坐标分量的绝对值都不超过 。
NOIP2010 普及组 第三题
题解
错误解法-贪心
- 遍历计算每个导弹到系统的距离,并把该导弹分配给离它最近的系统,维护系统的最大值
正解-枚举
- 枚举第一个圆的半径;
- 在没有包裹的点中,找出距离第二个点的最大半径,在枚举过程中求出半径和的最小值 **枚举方式
- 预处理出所有导弹到一个系统的距离,从大到小排序
- 从大到小枚举所有距离,这样每次只会额外出来一个点,因此就可以用这个点快速更新出第二个系统的最大距离
代码
#include <iostream>#include <algorithm>using namespace std;
const int N = 1e5 + 10;
int x1, y1, x2, y2; // 两个拦截系统的坐标int n; // 导弹数量
struct node{ int x, y, d; // 导弹坐标(x,y),d表示该导弹到第一个系统的距离平方}a[N];
// 计算第i个导弹到点(x,y)的距离平方int calc(int i, int x, int y){ int dx = x - a[i].x; int dy = y - a[i].y; return dx * dx + dy * dy; // 返回平方值,避免开方运算}
// 排序比较函数:按到第一个系统的距离从大到小排序bool cmp(node& a, node& b){ return a.d > b.d;}
int main(){ // 输入两个拦截系统的坐标 cin >> x1 >> y1 >> x2 >> y2; // 输入导弹数量 cin >> n;
// 读入每个导弹的坐标,并计算到第一个系统的距离平方 for(int i = 1; i <= n; i++) { cin >> a[i].x >> a[i].y; a[i].d = calc(i, x1, y1); // 计算到第一个系统的距离平方 }
// 按到第一个系统的距离从大到小排序 sort(a + 1, a + 1 + n, cmp);
// 初始值:第一个系统拦截所有导弹(半径为最远导弹的距离) int ret = a[1].d; int r2 = 0; // 第二个系统的半径平方,初始为0
// 关键枚举循环:i从2到n+1 for(int i = 2; i <= n + 1; i++) { // r1:第一个系统的半径平方(当前考虑的半径) int r1 = a[i].d;
// 更新第二个系统的半径:需要拦截前i-1个导弹中距离第二个系统最远的 // 注意:a[i-1]是刚刚加入第二个系统拦截范围的导弹 r2 = max(r2, calc(i - 1, x2, y2));
// 更新最小总代价:r1^2 + r2^2 ret = min(ret, r1 + r2); }
cout << ret << endl; return 0;}路径类DP
P1004 方格取数
题目描述
设有 的方格图 ,我们将其中的某些方格中填入正整数,而其他的方格中则放入数字 。如下图所示(见样例):
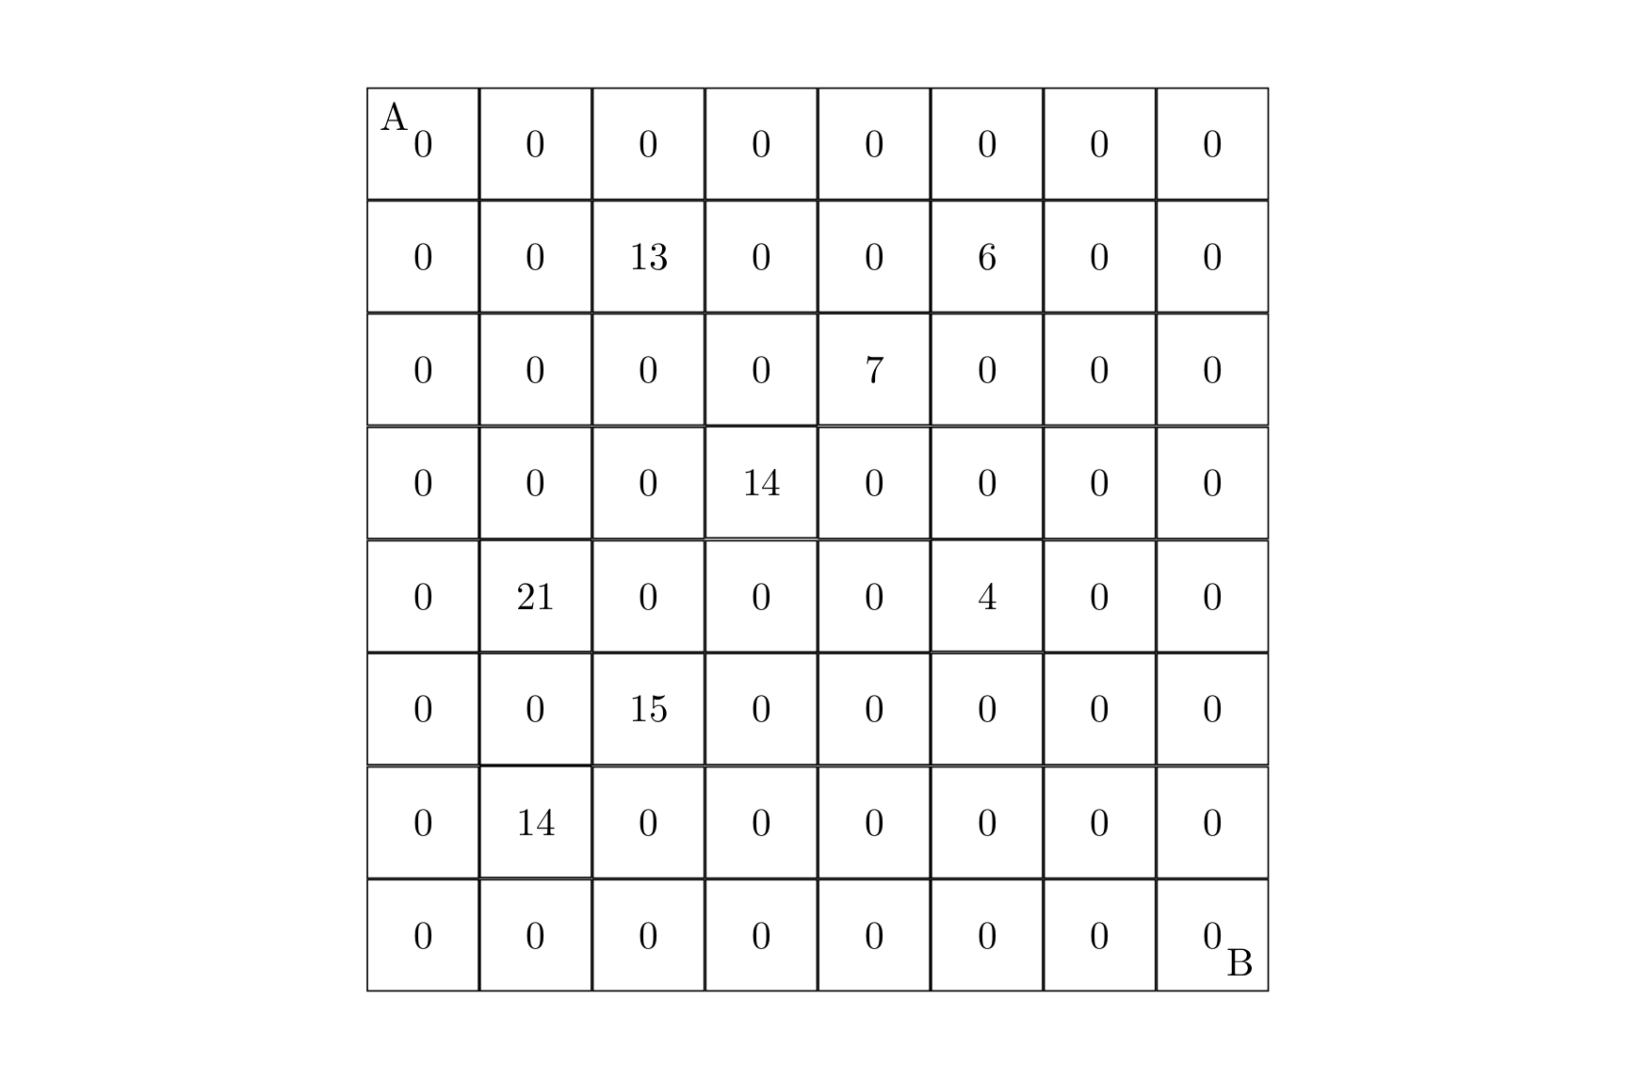
某人从图的左上角的 点出发,可以向下行走,也可以向右走,直到到达右下角的 点。在走过的路上,他可以取走方格中的数(取走后的方格中将变为数字 )。 此人从 点到 点共走两次,试找出 条这样的路径,使得取得的数之和为最大。
输入格式
输入的第一行为一个整数 (表示 的方格图),接下来的每行有三个整数,前两个表示位置,第三个数为该位置上所放的数。一行单独的 表示输入结束。
输出格式
只需输出一个整数,表示 条路径上取得的最大的和。
输入 #1
82 3 132 6 63 5 74 4 145 2 215 6 46 3 157 2 140 0 0输出 #1
67说明/提示
数据范围:。
题解
问题分析 贪心+两次是错误的,因为两次最优不等于全局最优,可以举出反例。正解应该是同时去走两条路,两者相互影响,所以放在一起考虑。
动态规划解法
-
状态表示 需要知道当前这两条路径走到什么位置,因此需要四维
f[i1][j1][i2][j2]来表示第一条路走到[i1, j1],第二条路走到[i2][j2]。 但是我们发现,因为两者是同时出发的,所以横纵坐标之和是一个定值。也就是说,只要知道了横纵坐标之和,以及两者的横坐标,就可以计算出纵坐标,状态表示就可以优化掉一维。 优化后的状态表示:f[st][i1][i2]表示:第一条路在[i1, st - i1],第二条路在[i2, st - i2]时,两者的路径最大和。 最终结果就是f[n × 2][n][n]。 -
状态转移方程 第一条路可以从上
[i1 - 1, st - i1]或者左[i1, st - i1 - 1]走到[i1, st - i1]位置;第二条路可以从上[i2 - 1, st - i2]或者左[i2, st - i2 - 1]走到[i2, st - i2]位置。排列组合一下一共4种情况,分别是:
- 上 + 上:
f[st - 1][i1 - 1][i2 - 1] - 上 + 左:
f[st - 1][i1 - 1][i2] - 左 + 上:
f[st - 1][i1][i2 - 1] - 左 + 左:
f[st - 1][i1][i2]取上面四种情况的最大值,然后再加上a[i1][j1]和a[i2][j2]。但是要注意,如果两个路径当前在同一位置时,只加上一个a[i1][j1]即可。
-
初始化 算的是路径和,0不会影响最终结果,直接填表。
-
填表顺序 先从小到大循环横纵坐标之和,然后依次从小到大循环两者的横坐标
#include <iostream>using namespace std;
const int N = 15;int n;int a[N][N]; // 存储每个格子的价值int f[N * 2][N][N]; // 动态规划数组:f[步数][第一条路径的行][第二条路径的行]
int main(){ cin >> n; // 输入网格大小 n x n
int x, y, w; // 输入网格中的价值,直到遇到 0 0 0 结束 while(cin >> x >> y >> w, x) { a[x][y] = w; }
// 动态规划:s 表示两条路径总共走的步数 for(int s = 2; s <= n + n; s++) // 从2开始:第一步从(1,1)到(1,1)需要2步 { for(int i1 = 1; i1 <= n; i1++) // 第一条路径当前所在行 { for(int i2 = 1; i2 <= n; i2++) // 第二条路径当前所在行 { int j1 = s - i1, j2 = s - i2; // 计算两条路径当前所在列
// 检查坐标是否越界 if(j1 <= 0 || j1 > n || j2 <= 0 || j2 > n) continue;
// 状态转移:考虑上一步的四种可能移动方式 int t = f[s - 1][i1][i2]; // 两条路径都向右移动 t = max(t, f[s - 1][i1][i2 - 1]); // 第一条向右,第二条向下 t = max(t, f[s - 1][i1 - 1][i2]); // 第一条向下,第二条向右 t = max(t, f[s - 1][i1 - 1][i2 - 1]); // 两条路径都向下移动
// 计算当前状态的最大价值 if(i1 == i2) { // 两条路径走到同一格子,价值只加一次 f[s][i1][i2] = t + a[i1][j1]; } else { // 两条路径走到不同格子,价值都加上 f[s][i1][i2] = t + a[i1][j1] + a[i2][j2]; } } } }
// 输出结果:两条路径都到达右下角(n,n)时的最大价值 cout << f[n + n][n][n] << endl;
return 0;}P7074 方格取数
题目描述
设有 的方格图,每个方格中都有一个整数。现有一只小熊,想从图的左上角走到右下角,每一步只能向上、向下或向右走一格,并且不能重复经过已经走过的方格,也不能走出边界。小熊会取走所有经过的方格中的整数,求它能取到的整数之和的最大值。
输入格式
第一行有两个整数 。
接下来 行每行 个整数,依次代表每个方格中的整数。
输出格式
一个整数,表示小熊能取到的整数之和的最大值。
输入 #1
3 41 -1 3 22 -1 4 -1-2 2 -3 -1输出 #1
9输入 #2
2 5-1 -1 -3 -2 -7-2 -1 -4 -1 -2输出 #2
-10说明/提示
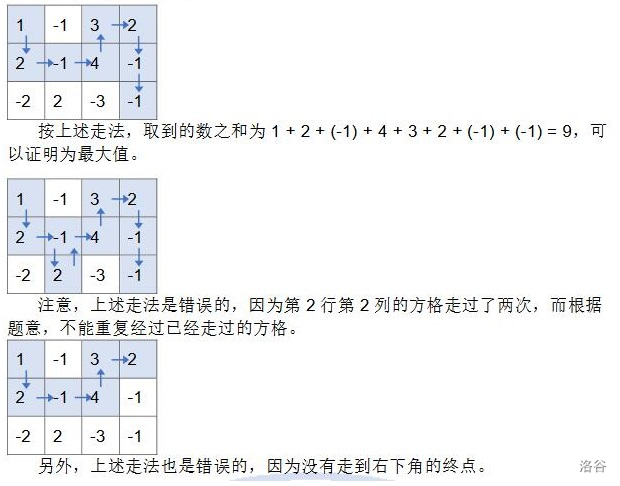
样例 1 解释
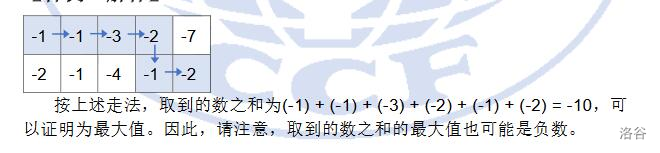
样例 2 解释
数据规模与约定
- 对于 的数据,。
- 对于 的数据,。
- 对于 的数据,。
- 对于 的数据,。方格中整数的绝对值不超过 。
题解
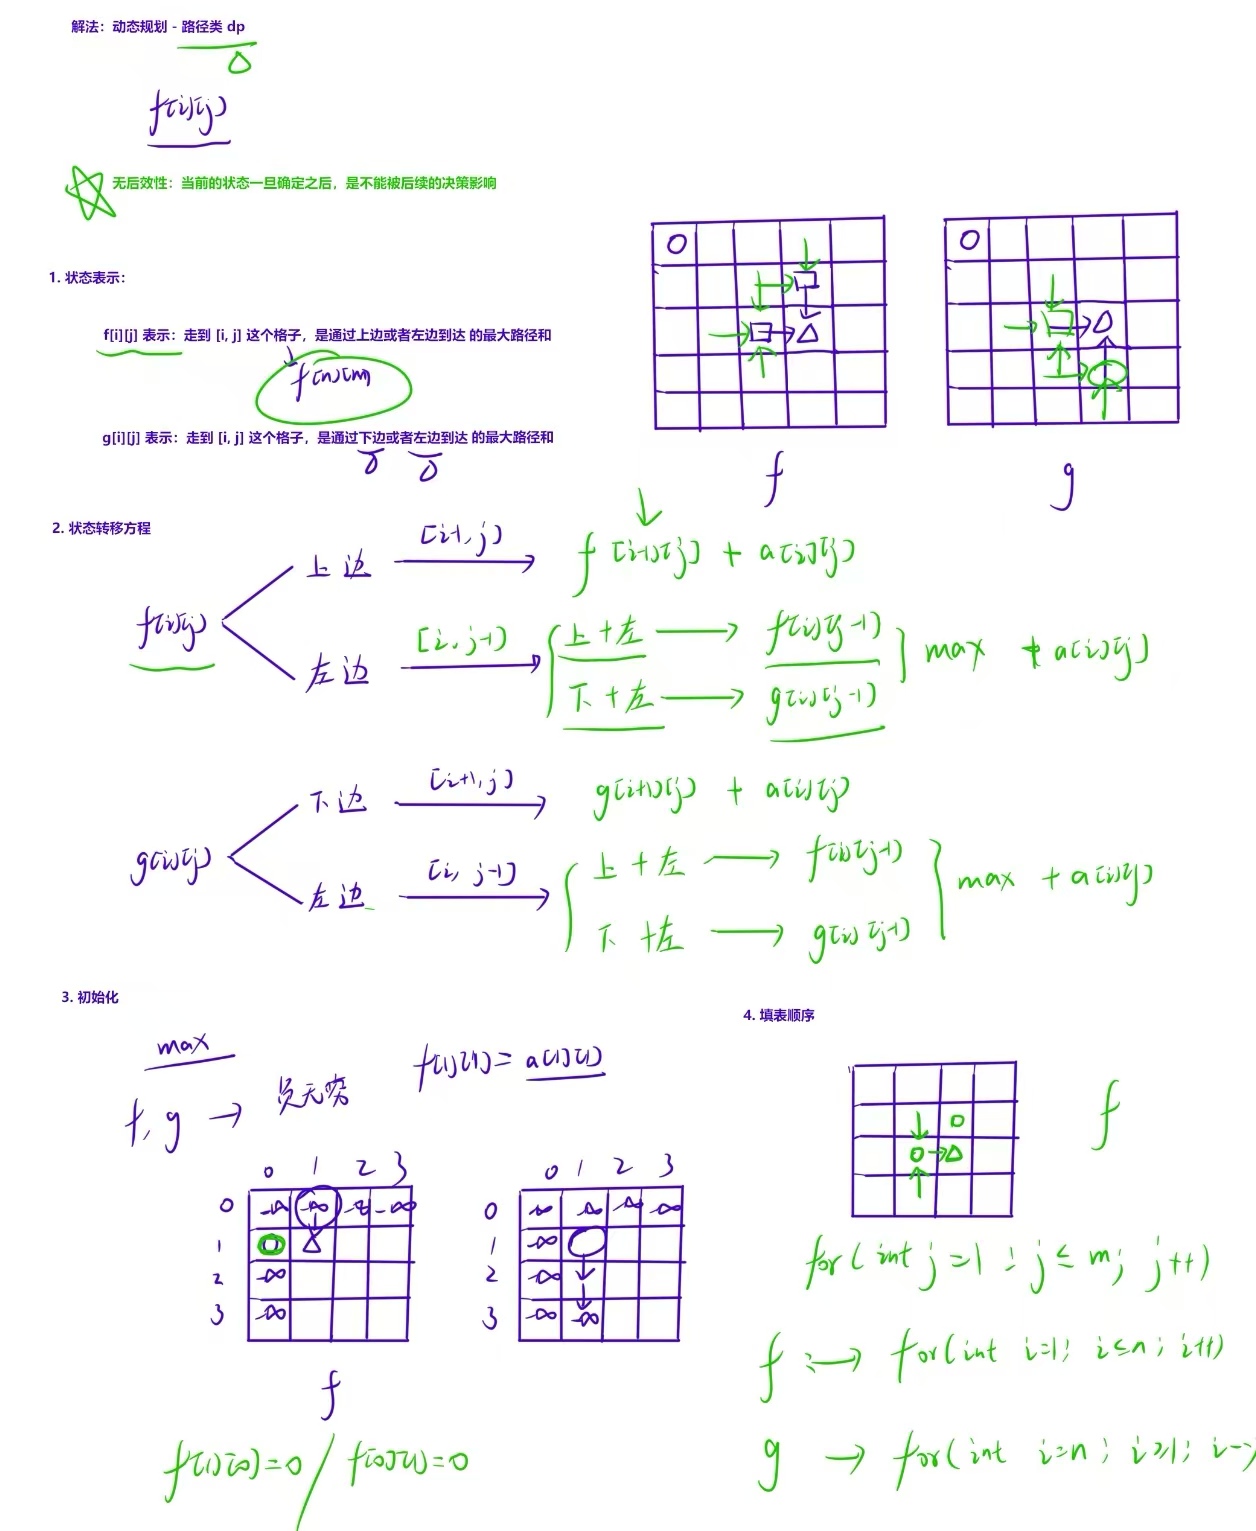
题目要求:
- 从左上角(1,1)到右下角(n,m)
- 可以向上、向下、向右走
- 不能向左走,不能重复经过格子
- 求最大整数和
关键难点
- 后效性问题:如果只用一个状态数组
dp[i][j],会有循环依赖- 因为可以从上方来,也可以从下方来
dp[i][j]可能依赖dp[i+1][j],而dp[i+1][j]又依赖dp[i][j]
- 解决思路:将状态分解为两个不同的”进入方向”
状态定义 定义两个状态数组:
-
f[i][j]:从上方或左方进入格子(i,j)能获得的最大和
- 即到达(i,j)时,最后一步是向下或向右移动
- 不能从下方进入(因为如果从下方进入,最后一步是向上移动)
-
g[i][j]:从下方或左方进入格子(i,j)能获得的最大和
- 即到达(i,j)时,最后一步是向上或向右移动
- 不能从上方进入
状态转移方程: 对于f[i][j](从上方或左方进入):
- 从上方来:
f[i-1][j] + a[i][j]- 因为从上方向下走进入(i,j)
- 从左方来(两种可能):
f[i][j-1] + a[i][j]:从左边向右走,且左边格子是从上方/左方进入的g[i][j-1] + a[i][j]:从左边向右走,且左边格子是从下方/左方进入的 所以:f[i][j] = max(f[i-1][j], f[i][j-1], g[i][j-1]) + a[i][j]
对于g[i][j](从下方或左方进入):
- 从下方来:
g[i+1][j] + a[i][j]- 因为从下方向上走进入(i,j)
- 从左方来(两种可能):
f[i][j-1] + a[i][j]:从左边向右走,且左边格子是从上方/左方进入的g[i][j-1] + a[i][j]:从左边向右走,且左边格子是从下方/左方进入的 所以:g[i][j] = max(g[i+1][j], f[i][j-1], g[i][j-1]) + a[i][j]
填表顺序 必须按列填表(先处理完一列的所有行,再处理下一列):
- 对于每列j,先从上到下计算f[i][j]
- 然后从下到上计算g[i][j]
- 再处理下一列j+1
为什么按列?
- 因为转移方程中,当前列j只依赖:
- 同一列的相邻行(f[i-1][j]、g[i+1][j])
- 前一列j-1(f[i][j-1]、g[i][j-1])
- 按列处理可以保证这些依赖项都已计算**
#include <iostream>#include <cstring>using namespace std;
typedef long long LL; // 使用long long类型,防止整数溢出const int N = 1010; // 定义最大网格大小
int n, m; // n:行数, m:列数int a[N][N]; // 存储每个方格中的整数LL f[N][N], g[N][N]; // f和g是两个动态规划状态数组
int main(){ // 读入网格的行数和列数 cin >> n >> m;
// 读入网格数据 for(int i = 1; i <= n; i++) for(int j = 1; j <= m; j++) cin >> a[i][j];
// 初始化DP数组为负无穷(0x3f是一个很大的数,取负就是负无穷) // 因为网格中可能有负数,所以不能初始化为0 memset(f, -0x3f, sizeof f); memset(g, -0x3f, sizeof g);
// 初始化起点:从(1,1)开始,只能是f状态(从上方或左方进入) f[1][1] = a[1][1];
// 按列进行动态规划(必须按列处理,否则会有后效性问题) for(int j = 1; j <= m; j++) // j表示当前列 { // 第一部分:计算f数组(从上到下遍历每一行) // f[i][j]表示从上方或左方进入(i,j)格子的最大和 for(int i = 1; i <= n; i++) // i表示当前行 { // 跳过起点(1,1),因为已经初始化过了 if(i == 1 && j == 1) continue;
// 状态转移:f[i][j]可以从三个方向转移过来 // 1. 从上方来:f[i-1][j](向下走一步) // 2. 从左方来,且左边格子是f状态:f[i][j-1](向右走一步) // 3. 从左方来,且左边格子是g状态:g[i][j-1](向右走一步) // 取三者中的最大值,然后加上当前格子的值 f[i][j] = max(f[i-1][j], max(f[i][j-1], g[i][j-1])) + a[i][j]; }
// 第二部分:计算g数组(从下到上遍历每一行) // g[i][j]表示从下方或左方进入(i,j)格子的最大和 for(int i = n; i >= 1; i--) // i表示当前行,从下往上 { // 状态转移:g[i][j]可以从三个方向转移过来 // 1. 从下方来:g[i+1][j](向上走一步) // 2. 从左方来,且左边格子是f状态:f[i][j-1](向右走一步) // 3. 从左方来,且左边格子是g状态:g[i][j-1](向右走一步) // 取三者中的最大值,然后加上当前格子的值 g[i][j] = max(g[i+1][j], max(f[i][j-1], g[i][j-1])) + a[i][j]; } }
// 输出结果:最终到达(n,m)格子,且必须是f状态 // 因为到达终点时,最后一步必须是向下或向右(不能向上或向左) // 所以终点必须是f状态(从上方或左方进入) cout << f[n][m] << endl;
return 0;}线性DP/最长上升子序列
P2285 打鼹鼠
题目描述
鼹鼠是一种很喜欢挖洞的动物,但每过一定的时间,它还是喜欢把头探出到地面上来透透气的。 根据这个特点阿牛编写了一个打鼹鼠的游戏:在一个 的网格中,在某些时刻鼹鼠会在某一个网格探出头来透透气。
你可以控制一个机器人来打鼹鼠,如果 时刻鼹鼠在某个网格中出现,而机器人也处于同一网格的话,那么这个鼹鼠就会被机器人打死。
而机器人每一时刻只能够移动一格或停留在原地不动。机器人的移动是指从当前所处的网格移向相邻的网格,即从坐标为 的网格移向 四个网格,机器人不能走出整个 的网格。
游戏开始时,你可以自由选定机器人的初始位置。
现在知道在一段时间内,鼹鼠出现的时间和地点,请编写一个程序使机器人在这一段时间内打死尽可能多的鼹鼠。
输入格式
第一行为 ,其中 表示在这一段时间内出现的鼹鼠的个数。
接下来的 行中每行有三个数据 ,表示在游戏开始后 个时刻,在第 行第 个网格里出现了一只鼹鼠。
按不降的顺序给出。
注意同一时刻可能出现多只鼹鼠,但同一时刻同一地点只可能出现一只鼹鼠。
输出格式
仅包含一个非负整数,表示被打死鼹鼠的最大数目。
输入 #1
2 21 1 12 2 2输出 #1
1题解
动态规划-最长上升子序列问题 这个问题看似需要暴力搜索或路径类动态规划,但实际上可以转化为最长上升子序列的变形。我们关注鼹鼠出现的时间序列,通过判断前后两只鼹鼠之间是否能够连续消灭,来找出最长的可连续消灭序列
-
状态表示 设
f[i]表示:如果消灭的最后一只鼹鼠是第i只时,最长能消灭多少只鼹鼠。那么f数组中的最大值就是我们要的结果。 -
状态转移方程 对于
f[i],可以分两种情况:
- 只消灭这一只鼹鼠,此时
f[i] = 1 - 将这只鼹鼠接在前面某只鼹鼠
j(1 ≤ j < i) 后面一起消灭,此时需要满足曼哈顿距离小于等于时间差的条件:abs(x[i] - x[j]) + abs(y[i] - y[j]) ≤ t[i] - t[j]那么f[i] = f[j] + 1 我们取所有符合要求的情况中的最大值作为f[i]` 的值。
-
初始化 不需要特殊初始化,直接填表即可。
-
填表顺序 从左往右依次计算每个
f[i]的值。 -
复杂度分析
- 时间复杂度:O(n²),其中 n 是鼹鼠的数量
- 空间复杂度:O(n),用于存储 f 数组
- 总结 通过将问题转化为最长上升子序列的变形,我们能够高效地解决这个看似复杂的路径问题。关键在于发现两只鼹鼠之间能否连续消灭只取决于它们的坐标差和时间差,而不需要关注中间的具体移动路径。
#include <iostream>using namespace std;
const int N = 1e4 + 10; // 定义最大鼹鼠数量
int n, m; // n: 网格大小,m: 鼹鼠数量int t[N], x[N], y[N]; // 分别存储每只鼹鼠的出现时间、x坐标、y坐标int f[N]; // f[i]表示以第i只鼹鼠结尾的最长消灭序列长度
int main(){ // 输入网格大小和鼹鼠数量 cin >> n >> m;
int ret = 0; // 记录最终答案(最长能消灭的鼹鼠数量)
// 遍历每只鼹鼠 for(int i = 1; i <= m; i++) { // 输入当前鼹鼠的出现时间、x坐标、y坐标 cin >> t[i] >> x[i] >> y[i];
// 初始化:至少可以消灭当前这只鼹鼠 f[i] = 1;
// 检查前面的所有鼹鼠,看能否接在它们后面消灭 for(int j = 1; j < i; j++) { // 判断条件:从消灭j到消灭i的时间是否足够移动 // 曼哈顿距离 <= 时间差 表示可以连续消灭 if(t[i] - t[j] >= abs(x[i] - x[j]) + abs(y[i] - y[j])) { // 如果可以接在j后面,更新最长序列长度 f[i] = max(f[i], f[j] + 1); } }
// 更新全局最大值 ret = max(ret, f[i]); }
// 输出最长能消灭的鼹鼠数量 cout << ret << endl;
return 0;}P2690 Apple Catching G
题目描述
很少有人知道奶牛爱吃苹果。农夫约翰的农场上有两棵苹果树(编号为 和 ), 每一棵树上都长满了苹果。奶牛贝茜无法摘下树上的苹果,所以她只能等待苹果 从树上落下。但是,由于苹果掉到地上会摔烂,贝茜必须在半空中接住苹果(没有人爱吃摔烂的苹果)。贝茜吃东西很快,她接到苹果后仅用几秒钟就能吃完。每一分钟,两棵苹果树其中的一棵会掉落一个苹果。贝茜已经过了足够的训练, 只要站在树下就一定能接住这棵树上掉落的苹果。同时,贝茜能够在两棵树之间 快速移动(移动时间远少于 分钟),因此当苹果掉落时,她必定站在两棵树其中的一棵下面。此外,奶牛不愿意不停地往返于两棵树之间,因此会错过一些苹果。苹果每分钟掉落一个,共 ()分钟,贝茜最多愿意移动 () 次。现给出每分钟掉落苹果的树的编号,要求判定贝茜能够接住的最多苹果数。 开始时贝茜在 1 号树下。
输入格式
第一行 个数, 和 。接下来的 行,每行一个数,代表在时刻 苹果是从 号苹果树还是从 号苹果树上掉下来的。
输出格式
对于每个测试点,输出一行,一个数,为奶牛最多接到的苹果的数量。
输入 #1
7 22112211输出 #1
6题解
这是一个经典的”接苹果”问题:
- 有两棵苹果树:1号树和2号树
- 每天有一棵苹果树会掉下苹果
- 初始位置在1号树
- 可以在树之间移动,但移动消耗次数
- 目标:在最多移动m次的情况下,接到最多的苹果
状态表示:
f[i][j]:前i天,移动了j次时,能获得的最大苹果数
状态转移方程 初始在1号树下
- 如果移动次数j是偶数:当前位置在1号树(初始位置)
- 如果移动次数j是奇数:当前位置在2号树
- 如果在1号树且一号树掉苹果(a[i]==1),要累加权值
- 如果在2号树且二号树掉苹果(a[i]==2),要累加权值
对于第i天,移动了j次
- 今天不移动:
- 苹果数 = 前i-1天移动j次的苹果数 + 今天能否接到苹果
f[i-1][j] + c
- 今天移动(如果j>0):
- 苹果数 = 前i-1天移动j-1次的苹果数 + 今天能否接到苹果
f[i-1][j-1] + c
- 取两者最大值:
f[i][j] = max(不移动的方案, 移动的方案)
#include <iostream>using namespace std;
const int N = 1010, M = 35; // N: 最大天数,M: 最大移动次数int n, m; // n: 实际天数,m: 最多可以移动的次数int a[N]; // a[i]: 第i天苹果树的位置(1或2)int f[N][M]; // f[i][j]: 前i天,移动了j次时能获得的最大苹果数
int main(){ cin >> n >> m; // 读入天数和最大移动次数
// 读入每天苹果树的位置(1号树或2号树) for(int i = 1; i <= n; i++) cin >> a[i];
// 动态规划求解 for(int i = 1; i <= n; i++) // 遍历每一天 { for(int j = 0; j <= m; j++) // 遍历可能的移动次数 { // 计算今天是否能接到苹果 // 规则:如果j是偶数,当前位置在1号树;如果j是奇数,当前位置在2号树 // 因为每次移动会改变位置(从1到2或从2到1) int c = 0; if(j % 2 == 0 && a[i] == 1 || (j % 2 == 1 && a[i] == 2)) c = 1; // 能接到苹果
// 状态转移:今天不移动的情况 f[i][j] = f[i - 1][j] + c;
// 状态转移:今天移动的情况(如果还有移动次数可用) if(j) f[i][j] = max(f[i][j], f[i - 1][j - 1] + c); } }
// 寻找最大苹果数 int ret = 0; for(int j = 0; j <= m; j++) { ret = max(f[n][j], ret); // 在最多移动m次的情况下,找到最大值 }
cout << ret << endl; // 输出结果 return 0;}P9242 接龙数列
题目描述
对于一个长度为 的整数数列:,我们称之为接龙数列当且仅当 的首位数字恰好等于 的末位数字()。
例如 是接龙数列; 不是接龙数列,因为 的首位数字不等于 的末位数字。所有长度为 的整数数列都是接龙数列。
现在给定一个长度为 的数列 ,请你计算最少从中删除多少 个数,可以使剩下的序列是接龙序列?
输入格式
第一行包含一个整数 。
第二行包含 个整数 。
输出格式
一个整数代表答案。
输入 #1
511 121 22 12 2023输出 #1
1说明/提示
【样例说明】
删除 ,剩余 是接龙数列。
【评测用例规模与约定】
对于 的数据,。
对于 的数据,。
对于 的数据,,。所有 保证不包含前导 0。
蓝桥杯 2023 省赛 B 组 E 题。
题解
算法原理:最长接龙子序列(动态规划) 这道题的核心思想是将问题转化为求最长接龙子序列的长度,然后用总长度减去这个最大值,得到最少需要删除的数量。
1. 问题转化 原问题:删除最少的数,使剩下的序列是接龙数列 等价于:找到最长的接龙子序列,然后用N减去这个长度
因为删除最少等价于保留最多,所以我们只需要找到能保留的最大数量。
2. 关键观察 对于接龙数列,每个数只关心两个特征:
-
首位数字(决定能否接在前一个数后面)
-
末位数字(决定下一个数能否接在自己后面
3. 状态设计
int f[i]; // 以第i个数结尾的最长接龙子序列长度int len[10]; // len[x]表示以数字x结尾的最长接龙子序列长度4. 状态转移
对于第i个数,设:
-
l= 首位数字(作为前驱条件) -
r= 末位数字(作为后继条件)
转移方程:
f[i] = len[l] + 1;-
这个数可以接在任意以l结尾的序列后面
-
len[l]就是目前以l结尾的最优序列长度
更新len数组
len[r] = max(len[r], f[i]);- 这个数以r结尾,更新以r结尾的最优长度
// 接龙数列问题:求最少删除多少个数使剩下的数列是接龙数列// 转化为求最长接龙子序列的长度,再用总长度减去它
#include<iostream>#include<string>using namespace std;
const int N = 1e5+10; // 数组最大长度int n;string s[N]; // 用字符串存储数字,方便取首位和末位int f[N]; // f[i]:以第i个数结尾的最长接龙子序列的长度int len[15]; // len[x]:以数字x结尾的最长接龙子序列的长度(数字只有0-9)int ret = 0; // 记录最长接龙子序列的长度
int main(){ cin>>n; // 输入n个数字(用字符串形式存储) for(int i=1;i<=n;i++)cin>>s[i];
// 动态规划求解最长接龙子序列 for(int i=1;i<=n;i++) { // l:当前数的首位数字,r:当前数的末位数字 int l = s[i][0] - '0'; // 首位数字 int r = s[i][s[i].size()-1] - '0'; // 末位数字
// 当前数可以接在任意以l结尾的序列后面 f[i] = len[l] + 1; // len[l]是目前以l结尾的最优长度
// 更新以r结尾的最优长度 len[r] = max(f[i], len[r]);
// 更新全局最优解 ret = max(ret, f[i]); }
// 输出最少删除数量 = 总数 - 最长接龙子序列长度 cout<<n-ret<<endl;
return 0;}
/*算法核心思想:1. 每个数只关心两个特征:首位数字(l)和末位数字(r)2. len数组记录以每个数字(0-9)结尾的最长接龙子序列长度3. 对于当前数,它可以接在任意以l结尾的序列后面,所以f[i] = len[l] + 14. 当前数以r结尾,所以更新len[r] = max(len[r], f[i])5. 最终ret就是最长接龙子序列的长度6. 答案 = n - ret
时间复杂度:O(n),空间复杂度:O(n)*/扩展域查并集
P1525 关押罪犯
题目描述
S 城现有两座监狱,一共关押着 名罪犯,编号分别为 。他们之间的关系自然也极不和谐。很多罪犯之间甚至积怨已久,如果客观条件具备则随时可能爆发冲突。我们用“怨气值”(一个正整数值)来表示某两名罪犯之间的仇恨程度,怨气值越大,则这两名罪犯之间的积怨越多。如果两名怨气值为 的罪犯被关押在同一监狱,他们俩之间会发生摩擦,并造成影响力为 的冲突事件。
每年年末,警察局会将本年内监狱中的所有冲突事件按影响力从大到小排成一个列表,然后上报到 S 城 Z 市长那里。公务繁忙的 Z 市长只会去看列表中的第一个事件的影响力,如果影响很坏,他就会考虑撤换警察局长。
在详细考察了 名罪犯间的矛盾关系后,警察局长觉得压力巨大。他准备将罪犯们在两座监狱内重新分配,以求产生的冲突事件影响力都较小,从而保住自己的乌纱帽。假设只要处于同一监狱内的某两个罪犯间有仇恨,那么他们一定会在每年的某个时候发生摩擦。
那么,应如何分配罪犯,才能使 Z 市长看到的那个冲突事件的影响力最小?这个最小值是多少?
输入格式
每行中两个数之间用一个空格隔开。第一行为两个正整数 ,分别表示罪犯的数目以及存在仇恨的罪犯对数。接下来的 行每行为三个正整数 ,表示 号和 号罪犯之间存在仇恨,其怨气值为 。数据保证 ,且每对罪犯组合只出现一次。
输出格式
共一行,为 Z 市长看到的那个冲突事件的影响力。如果本年内监狱中未发生任何冲突事件,请输出 0。
输入 #1
4 61 4 25342 3 35121 2 283511 3 66182 4 18053 4 12884输出 #1
3512说明/提示
输入输出样例说明
罪犯之间的怨气值如下面左图所示,右图所示为罪犯的分配方法,市长看到的冲突事件影响力是 (由 号和 号罪犯引发)。其他任何分法都不会比这个分法更优。
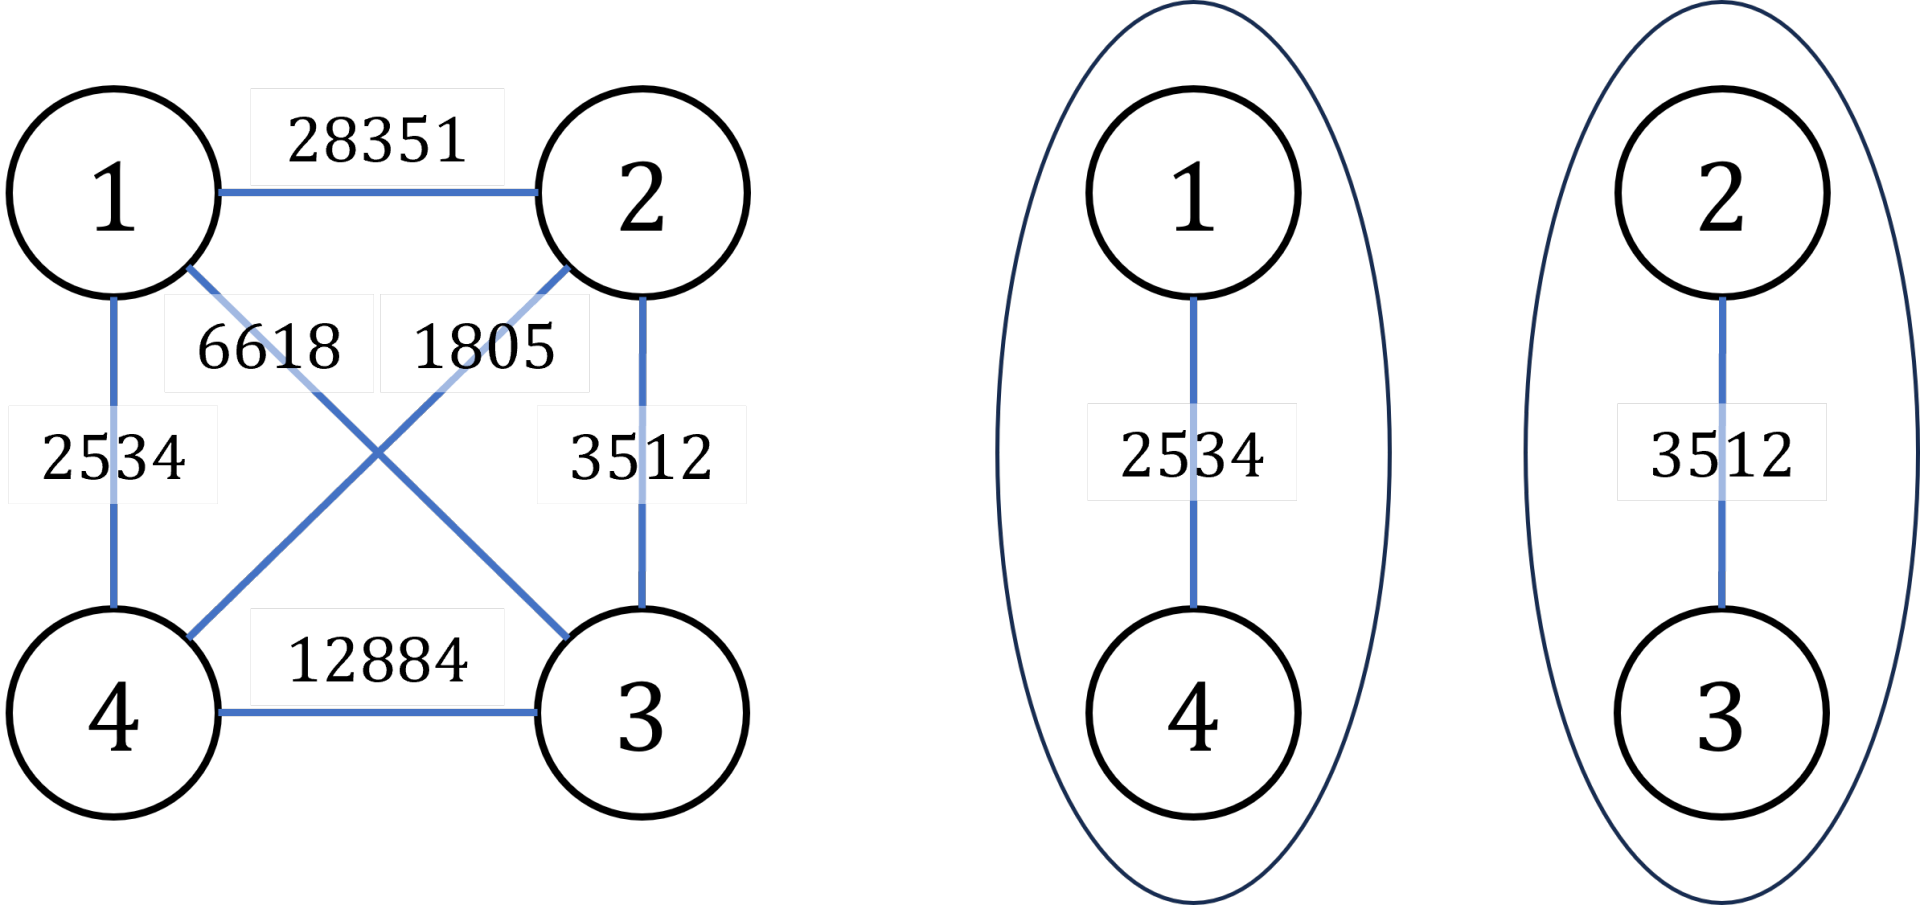 数据范围
对于 的数据有 。
对于 的数据有 。
对于 的数据有 。
题解
贪心 + 扩展域并查集。
1. 问题建模
- 将罪犯分成两个监狱,使同一监狱内的最大仇恨值最小
- 等价于:优先把仇恨值大的罪犯分到不同监狱-
2. 扩展域并查集
- 1~n域:表示罪犯本身所在的集合
- n+1~2n域:表示该罪犯的”敌人”集合
- 当说”a和b+n合并”时,意思是:a和b的敌人应该是朋友
3. 贪心策略
- 从仇恨值最大的矛盾开始处理
- 尽量把仇恨值大的罪犯分到不同监狱
- 当发现两个罪犯无法分到不同监狱时,当前的仇恨值就是答案
- 关键逻辑
- un(a, b + n); // a与b的敌人是朋友
- un(b, a + n); // b与a的敌人是朋友 这建立了:如果a和b是敌人,那么:
- a应该和b的朋友是敌人
- b应该和a的朋友是敌人
冲突检测
if(find(a) == find(b)) 检查a和b是否已经是朋友
- 如果是,说明之前的分配已经让他们在同一个监狱
- 但当前矛盾要求他们必须在不同监狱 → 冲突发生 时间复杂度:O(m log m)(主要来自排序) 空间复杂度:O(n)
#include <iostream>#include <algorithm>using namespace std;
const int N = 4e4 + 10, M = 1e5 + 10;
int n, m;struct node{ int a, b, c; // a,b:两个罪犯编号, c:仇恨值}e[M];
int fa[N]; // 并查集数组
// 并查集查找函数(带路径压缩)int find(int x){ return fa[x] == x ? x : fa[x] = find(fa[x]);}
// 并查集合并函数void un(int x, int y){ fa[find(x)] = find(y);}
// 按仇恨值从大到小排序bool cmp(node& x, node& y){ return x.c > y.c;}
int main(){ cin >> n >> m; // n:罪犯数量, m:矛盾数量
// 输入所有矛盾关系 for(int i = 1; i <= m; i++) cin >> e[i].a >> e[i].b >> e[i].c;
// 初始化并查集:扩展为2倍,用于表示"敌人"关系 // 1~n: 表示罪犯本身 // n+1~2n: 表示罪犯的敌人集合 for(int i = 1; i <= n + n; i++) fa[i] = i;
// 按仇恨值从大到小排序(贪心:优先处理仇恨值大的矛盾) sort(e + 1, e + 1 + m, cmp);
// 遍历所有矛盾关系 for(int i = 1; i <= m; i++) { int a = e[i].a, b = e[i].b, c = e[i].c;
// 关键操作:建立敌人关系 // 将a与b的敌人集合合并,将b与a的敌人集合合并 un(a, b + n); // a和b的敌人是朋友 un(b, a + n); // b和a的敌人是朋友
// 检查a和b是否已经在同一个集合(即是否已经是朋友) // 如果是,说明无法将他们分到不同监狱,当前仇恨值就是答案 if(find(a) == find(b)) { cout << c << endl; return 0; } }
// 如果所有矛盾都能妥善处理,输出0 cout << 0 << endl; return 0;}滑动窗口
P12280 蓝桥杯 2024 国 Python A 特别的数组
题目描述
如果一个数组中的所有元素都互不相同,我们称其为一个特别的数组。
给定一个数组 ,你可以选择一对 并将数组中的第 至 个元素移除。求对给定的数组进行一次这样的操作后可以得到的特别的数组的长度最大是多少。
输入格式
输入的第一行包含一个整数 ,表示数组的长度。
第二行包含 个整数 ,相邻整数之间使用一个空格分隔。
输出格式
输出一行包含一个整数表示进行一次移除操作后可以得到的特别的数组的最大长度。
输入 #1
91 2 3 4 2 5 7 6 3输出 #1
7样例说明
移除第 个元素可以得到 。
评测用例规模与约定
- 对于 的评测用例,;
- 对于所有评测用例,。
题解
1. 题目大意与核心转化(正难则反)
题目要求我们在数组中删除一段连续的子数组,使得剩余的数组中所有元素互不相同(即没有重复元素),并且要求剩余的数组长度最大。
与其去硬凑“剩余部分”,不如将目光聚焦于“被删除的部分”。
-
转化 1:剩余数组长度最大 被删除的子数组长度最短。
-
转化 2:剩余数组无重复元素 原数组中所有多出来的重复元素,都必须被包含在被删除的子数组 中。
2. 思路推导:从暴力到双指针
暴力解法(50分):
直接枚举被删除区间的左端点 和右端点 ,然后用一个 的 check() 函数检查剩余元素是否有重复。
这种做法的时间复杂度高达 ,即使优化掉 check 也能达到 ,对于 的数据必定超时。痛点在于盲目枚举了大量完全没必要的区间。
破局点:发现“单调性”
假设你当前删除了区间 ,发现剩余数组已经没有重复元素了(区间合法)。
-
向右扩张必定合法:如果多删几个元素(即 继续向右),剩余的元素只会更少,绝不可能凭空产生新的重复元素。
-
寻找最优解必须收缩:既然 已经合法,为了让删除的长度尽量短,我们下一步应该尝试缩小被删除的区间,也就是把左端点 向右移动,看看少删一个元素是否依然合法。
这种“右端点扩张寻找可行解,左端点收缩优化最优解”的单调特征,完美契合滑动窗口(双指针)算法。
3. 核心逻辑与状态维护
为了避免 的轮询检查,我们需要实现 的状态转移。
引入两个核心变量:
-
cnt[x]:记录数字x在剩余数组中的出现次数。 -
kind:记录当前剩余数组中,有多少种数字的出现次数 。- 当
kind == 0时,说明剩余数组完全没有重复元素,当前滑动窗口合法。
- 当
滑动窗口流程:
-
预处理:先统计原数组中所有元素的频次,算出初始的
kind。如果kind == 0,说明原数组本来就不重复,直接输出 并结束。 -
扩张(移动 ):尝试删除 。剩余数组中
a[R]的数量减少(cnt[a[R]]--)。如果减少后刚好变成了 ,说明这个数字的重复问题被解决了,违规种类减少(kind--)。 -
收缩(移动 ):只要当前窗口合法(
kind == 0),我们就记录当前剩余数组的长度n - (R - L + 1)并尝试更新最大值ret。然后,我们尝试将 移出删除区间(即“捡回”剩余数组中),cnt[a[L]]++。如果捡回后导致cnt[a[L]] == 2,说明重新产生了重复,违规种类增加(kind++),窗口变为不合法,停止收缩,继续移动 。
4. 复杂度分析
-
时间复杂度:。左右指针 和 都最多只遍历数组一次,所有的状态更新(
cnt数组和kind变量)都在 时间内完成。 -
空间复杂度:。需要一个长度为 的
cnt数组来记录每个数字出现的频率。
5. 完整 AC 代码
#include<iostream>using namespace std;
const int N = 1e5 + 10;int n;int a[N];int cnt[N];int ret = -1;int kind = 0; // 记录剩余数组中有多少种数字出现了 2 次及以上
int main(){ // 优化输入输出速度 ios::sync_with_stdio(false); cin.tie(0);
cin >> n; // 1. 预处理:统计原数组的状态 for(int i = 1; i <= n; i++) { cin >> a[i]; cnt[a[i]]++; // 某元素出现次数达到 2 次,违规种类 +1 if(cnt[a[i]] == 2) kind++; }
// 特判:如果本身就不含重复元素,直接输出总长度 n if(kind == 0) { cout << n << "\n"; return 0; }
// 2. 双指针 / 滑动窗口 // L 和 R 维护的是“被删除的连续子数组”的左右端点 for(int l = 1, r = 1; r <= n; r++) { // 尝试删除 a[r],即在剩余数组中扣除该元素 cnt[a[r]]--; // 如果扣除后,该元素在剩余数组中刚好只剩 1 个,说明这种数字的重复问题解决了 if(cnt[a[r]] == 1) kind--;
// 当违规种类为 0,说明当前删除 [L, R] 后剩余数组合法 while(kind == 0) { // 更新最大的剩余长度:原长度 n 减去 被删除区间长度 (r - l + 1) ret = max(ret, n - (r - l + 1));
// 尝试收缩窗口(缩小被删除的区间):将 a[l] 重新加回剩余数组中 cnt[a[l]]++; // 如果加回来导致该元素再次重复,违规种类 +1,打破 while 循环 if(cnt[a[l]] == 2) kind++;
l++; // 左端点右移 } }
cout << ret << "\n";
return 0;}P3143 Diamond Collector S
题目描述
奶牛 Bessie 一直喜欢闪闪发光的物体,她最近在业余时间开始了一项爱好——挖掘钻石!她收集了 颗大小各不相同的钻石(),并希望将它们中的一部分放在谷仓里的两个展示柜中展示。
由于 Bessie 希望每个展示柜中的钻石大小相对接近,她决定如果两颗钻石的大小相差超过 ,就不能将它们放在同一个展示柜中(如果两颗钻石的大小相差恰好为 ,则可以将它们一起展示在同一个展示柜中)。给定 ,请帮助 Bessie 确定她可以在两个展示柜中一起展示的最大钻石数量。
输入格式
输入文件的第一行包含 和 ()。
接下来的 行每行包含一个整数,表示一颗钻石的大小。所有钻石的大小均为正数且不超过 。
输出格式
输出一个正整数,表示 Bessie 可以在两个展示柜中一起展示的最大钻石数量。
输入 #1
7 31051129514输出 #1
5题解
错误解法的局限性
一种直观但错误的思路是:先选一段「最长」的满足条件的子数组,再选一段「次长」的。但这种方法是错误的,因为第一次的选择会影响第二次的选择,两者加起来「不一定是全局最优」。
反例:[1, 1, 4, 5, 6, 7, 8, 10], k = 3
- 如果先选
[4, 5, 6, 7],接下来只能选[1, 1]或[8, 10],总长度为 6 - 但最优解是先选
[5, 6, 7, 8],再选[1, 1, 4],总长度为 7 这说明贪心选择局部最长段并不能得到全局最优解。
正确解法:枚举分割点
我们可以「枚举」所有可能的情况:以位置 i 为「分界点」,将数组分成左右两部分:
- 左边:在
[1, i-1]区间内,选择符合要求的「最长子串」 - 右边:在
[i, n]区间内,选择符合要求的 [ 最长子串 ]
这样我们就能枚举出所有可能的分割方式,取「左右两部分长度之和」的最大值就是最终结果。
预处理方法
为了快速查询任意区间内的最长子串长度,我们需要进行预处理:
定义预处理数组:
f[i]:表示[1, i]区间内符合要求的「最长子串」长度g[i]:表示[i, n]区间内符合要求的「最长子串」长度
计算 f[i] 的方法: 对于每个位置 i,有两种可能:
- 最长子串不包含 a[i],即
f[i-1] - 最长子串包含 a[i],即以 a[i] 为结尾的最长子串长度
取两者的最大值作为
f[i]
计算 g[i] 的方法(同理): 对于每个位置 i,有两种可能:
- 最长子串不包含 a[i],即
g[i+1] - 最长子串包含 a[i],即以 a[i] 为起始的最长子串长度
取两者的最大值作为
g[i]
如何快速计算「以 a[i] 为结尾」的最长子串长度?
使用「滑动窗口」技术:
- 维护一个滑动窗口,保证窗口内最大值与最小值的差 ≤ k
- 当窗口扩展时,如果差值超过 k,则收缩左边界
- 对于每个右端点 right,窗口长度
right-left+1就是「以 a[right] 为结尾」的最长子串长度 - 一次滑动窗口遍历,可以预处理出所有位置的信息 滑动窗口是两指针不回退,一个指针一步一步向前走,一个指针违反限制就收缩若干格,因为要保证i-n都有数据,因此要用一步步的那个指针处理数据,也因此g[i]和f[i]要分别使用双指针
整体算法流程
- 排序:先对数组排序,使得可以使用双指针
- 正向预处理:使用滑动窗口计算 f[i],表示前 i 个元素的最优解
- 反向预处理:同样使用滑动窗口(反向)计算 g[i],表示从 i 开始的最优解
- 枚举分割点:遍历所有可能的分割点 i,计算
f[i-1] + g[i]的最大值
#include <iostream>#include <algorithm>using namespace std;
const int N = 5e4 + 10; // 最大数据范围int n, k; // n: 元素个数, k: 最大差值限制int a[N]; // 存储原始数组
int f[N], g[N]; // f[i]: 前i个元素中满足条件的最长子数组长度 // g[i]: 从第i个元素到末尾满足条件的最长子数组长度
int main(){ cin >> n >> k; // 读入元素个数和差值限制
// 读入数组 for(int i = 1; i <= n; i++) cin >> a[i];
// 对数组进行排序,方便使用双指针 sort(a + 1, a + 1 + n);
// 预处理 f[i]: 以i为右端点,满足条件的最大连续子数组长度 // 使用双指针维护滑动窗口 for(int left = 1, right = 1; right <= n; right++) { // 当当前窗口的最大最小值差超过k时,收缩左指针 while(a[right] - a[left] > k) left++;
// f[right]表示前right个元素中满足条件的最大长度 // 要么包含当前right(即right-left+1),要么不包含(f[right-1]) f[right] = max(f[right - 1], right - left + 1); }
// 预处理 g[i]: 以i为左端点,满足条件的最大连续子数组长度 // 同样使用双指针,从后往前扫描 for(int left = n, right = n; left >= 1; left--) { // 当当前窗口的最大最小值差超过k时,收缩右指针 while(a[right] - a[left] > k) right--;
// g[left]表示从left开始到末尾满足条件的最大长度 // 要么包含当前left(即right-left+1),要么不包含(g[left+1]) g[left] = max(g[left + 1], right - left + 1); }
// 寻找最优分割点,将数组分成两部分,使得两部分长度之和最大 int ret = 0; for(int i = 2; i <= n; i++) // i表示分割点(第二部分从i开始) { // 前i-1个元素的最优解 + 从i开始的最优解 ret = max(ret, f[i - 1] + g[i]); }
cout << ret << endl; // 输出结果 return 0;}P10710 School Photo
题目描述
Zane 是 NOI 学校的校长。NOI 学校有 个班,每个班有 名同学。第 个班中的第 名同学的身高是 。
现在 Zane 想从每个班上选出一名同学拍照,使得这 名同学中最高的同学和最低的同学的身高差最小。
请你输出这个最小值。
输入格式
第一行,两个整数 ;
接下来 行,每行 个整数,表示 。
输出格式
一行一个整数表示答案。
输入 #1
2 32 1 85 4 7输出 #1
1输入 #2
3 33 1 42 7 189 8 10输出 #2
4说明/提示
【样例 #2 解释】
选择 ,答案为 。
【数据范围】
| 分值 | 特殊性质 | |
|---|---|---|
| 样例 | ||
| 无 |
对于 的数据,。
题解
问题理解 我们有:
n个班级- 每个班级有
s个学生 - 要从每个班选一个学生
- 要最小化:选出的n个学生中最高和最矮的身高差
关键转化: 如果我们把所有学生按身高排序,问题转化为: 在排序后的数组中,找一个最短的连续子数组,这个子数组包含所有n个班级的学生。
**思路
- 将所有⼈的⾝⾼与班级绑定,从⼩到⼤排序;
- 问题就变成在⼀个数组中,挑出连续的⼀段,使⾥⾯的学⽣包含所有班级。在所有的挑法中,找出最⼤⾝⾼ - 最⼩⾝⾼的最⼩值。
- 可以⽤滑动窗⼝来解决。
**两变量
cnt[i]:记录当前窗口中班级i的学生数量kind:记录当前窗口中包含的不同班级数量
#include <iostream>#include <algorithm>using namespace std;
const int N = 1010, M = N * N; // N:最大班级数,M:最大学生总数
int n, s, m; // n:班级数,s:每班人数,m:总人数struct node{ int h, id; // h:身高,id:班级编号(1~n)}a[M];int cnt[N]; // 计数器,记录当前窗口中每个班级的学生数
// 比较函数:按身高升序排序bool cmp(node& x, node& y){ return x.h < y.h;}
int main(){ // 读入数据 cin >> n >> s;
// 读入所有学生信息 for(int i = 1; i <= n; i++) // i是班级编号 { for(int j = 1; j <= s; j++) // j是班级内学生序号 { m++; // 总人数+1 cin >> a[m].h; // 读入身高 a[m].id = i; // 记录班级编号 } }
// 将所有学生按身高从小到大排序 sort(a + 1, a + 1 + m, cmp);
// 初始化答案为无穷大 int ret = 1e9;
// 滑动窗口(双指针) // l:窗口左指针,r:窗口右指针,kind:窗口中包含的不同班级数 for(int l = 1, r = 1, kind = 0; r <= m; r++) { // 将a[r]加入窗口 cnt[a[r].id]++;
// 如果这个班级之前不在窗口中(cnt从0变成1) // 则窗口中包含的班级种类数+1 if(cnt[a[r].id] == 1) kind++;
// 当窗口包含所有班级时,尝试缩小窗口 while(kind == n) { // 更新答案:当前窗口的身高差 ret = min(ret, a[r].h - a[l].h);
// 将a[l]移出窗口 cnt[a[l].id]--;
// 如果这个班级的学生全部移出窗口(cnt从1变成0) // 则窗口中包含的班级种类数-1 if(cnt[a[l].id] == 0) kind--;
// 左指针右移,缩小窗口 l++; } }
// 输出最小身高差 cout << ret << endl;
return 0;}正难则反
P3916 图的遍历
题目描述
给出 个点, 条边的有向图,对于每个点 ,令 表示从点 出发,能到达的编号最大的点。现在请求出 的值。
输入格式
第 行 个整数 ,表示点数和边数。
接下来 行,每行 个整数 ,表示边 。点用 编号。
输出格式
一行 个整数 。
输入 #1
4 31 22 44 3输出 #1
4 4 3 4说明/提示
- 对于 的数据,。
- 对于 的数据,。
题解
从任意⼀点出发,去找能到达的最⼤结点,时间复杂度巨⾼。但是如果对原图建⼀个反图,从节点编号最⼤的点出发,能⾛到的点都是原图能到达的点。 因此,建⼀个反图,按照节点编号从⼤到⼩搜索⼀遍即可。
#include <iostream>#include <vector>using namespace std;
const int N = 1e5 + 10; // 定义最大节点数,100010个节点int n, m; // n: 节点数量,m: 边数量vector<int> edges[N]; // 邻接表存储图,edges[u]存储从u出发能到达的节点int ret[N]; // ret[i]存储节点i能到达的最大编号节点(在反图中)
/** * 深度优先搜索函数 * @param u 当前遍历的节点 * @param r 当前连通分量的根节点(即本轮DFS的起始节点) * * 功能:在反图中标记所有从u可达的节点,将它们能到达的最大节点标记为r */void dfs(int u, int r){ ret[u] = r; // 标记节点u能到达的最大节点为r
// 遍历u的所有邻接节点(在反图中) for(auto v : edges[u]) { if(ret[v]) continue; // 如果v已经被访问过,跳过 dfs(v, r); // 递归遍历v }}
int main(){ // 输入节点数和边数 cin >> n >> m;
// 读取所有边,建立反图 for(int i = 1; i <= m; i++) { int a, b; cin >> a >> b; // 建反图:在原图中是a->b,在反图中是b->a // 这样在反图中,从b能到达a,意味着在原图中a能到达b edges[b].push_back(a); }
/** * 核心算法:按节点编号从大到小遍历 * 从编号大的节点开始DFS,这样: * 1. 如果一个节点还没有被访问,说明它是它所在连通分量中编号最大的 * 2. 在反图中DFS,实际上是在找原图中能到达当前节点的所有节点 */ for(int i = n; i >= 1; i--) { if(ret[i]) continue; // 如果节点i已经被访问过,跳过 dfs(i, i); // 从节点i开始DFS,根节点设为i }
// 输出结果 for(int i = 1; i <= n; i++) { cout << ret[i] << " "; }
return 0;}P1209 修理牛棚 Barn Repair
题目描述
在一个月黑风高的暴风雨夜,Farmer John 的牛棚的屋顶、门被吹飞了 好在许多牛正在度假,所以牛棚没有住满。
牛棚一个紧挨着另一个被排成一行,牛就住在里面过夜。有些牛棚里有牛,有些没有。 所有的牛棚有相同的宽度。
自门遗失以后,Farmer John 必须尽快在牛棚之前竖立起新的木板。他的新木材供应商将会供应他任何他想要的长度,但是吝啬的供应商只能提供有限数目的木板。 Farmer John 想将他购买的木板总长度减到最少。
给出 ,表示木板最大的数目、牛棚的总数、牛的总数;以及每头牛所在牛棚的编号,请算出拦住所有有牛的牛棚所需木板的最小总长度。
输入格式
一行三个整数 ,意义如题目描述。 接下来 行,每行包含一个整数,表示牛所占的牛棚的编号。
输出格式
输出一行一个整数,表示所需木板的最小总长度。
输入 #1
4 50 1834681415161721252627303140414243输出 #1
25说明/提示
【数据范围】 对于 的数据,,。
题解-正难则反+贪心
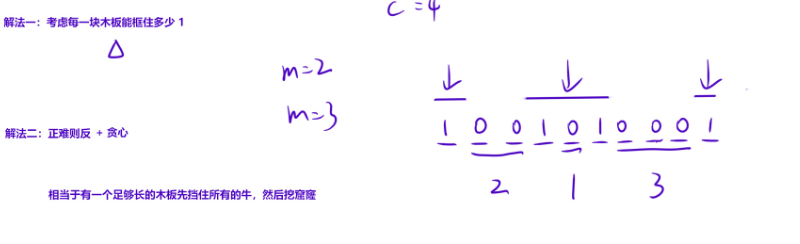
思考: 可以先来⼀块⾜够⻓的⽊板挡住所有的⽜棚,然后按照挖出 m - 1 个最⻓的窟窿。
具体做法: - 计算相邻有牛棚之间的间隔(空隙) - 选择最大的m-1个间隔断开 - 总长度 = 总覆盖范围 - 这些间隔的长度
#include <iostream>#include <algorithm>using namespace std;
const int N = 210; // 最大牛棚数量,根据题目c≤200int m, s, c; // m:最大木板数,s:牛棚总数,c:有牛的牛棚数int a[N]; // 存储有牛的牛棚编号int b[N]; // 存储相邻有牛牛棚之间的间隔(空隙)
// 比较函数:降序排序(从大到小)bool cmp(int a, int b){ return a > b; // 返回true表示a应该排在b前面}
int main(){ // 输入数据 cin >> m >> s >> c;
// 读取有牛的牛棚编号 for(int i = 1; i <= c; i++) cin >> a[i];
// 1. 对牛棚编号进行升序排序 // 排序原因:需要按照牛棚位置顺序处理 sort(a + 1, a + 1 + c);
// 2. 计算相邻有牛牛棚之间的间隔 // 间隔 = 后一个牛棚编号 - 前一个牛棚编号 - 1 // 例如:牛在3号和6号牛棚,间隔 = 6-3-1 = 2(中间有4、5两个空牛棚) for(int i = 1; i < c; i++) { b[i] = a[i + 1] - a[i] - 1; }
// 3. 对间隔数组进行降序排序 // 将最大的间隔放在前面,便于后续贪心选择 sort(b + 1, b + 1 + c, cmp); // 注意:b数组实际有效数据是b[1]到b[c-1],b[c]是未初始化的 // 但因为后面只用到前m-1个,且m≤c,所以不会访问到无效数据
// 4. 计算初始总长度:用一块长木板覆盖所有有牛的牛棚 // 长度 = 最后一个牛棚编号 - 第一个牛棚编号 + 1 int ret = a[c] - a[1] + 1;
// 5. 贪心策略:断开最大的(m-1)个间隔 // 每断开一个间隔,总长度减少该间隔的长度 // 循环条件:i < m 且 i < c // - i < m:最多可以断开m-1个间隔(因为i从1开始) // - i < c:不能超过间隔总数(c-1个间隔) for(int i = 1; i < m && i < c; i++) { ret -= b[i]; // 减去第i大的间隔 }
// 6. 输出最小总长度 cout << ret << endl;
return 0;}摇摆序列
P1970 花匠
题目描述
花匠栋栋种了一排花,每株花都有自己的高度。花儿越长越大,也越来越挤。栋栋决定把这排中的一部分花移走,将剩下的留在原地,使得剩下的花能有空间长大,同时,栋栋希望剩下的花排列得比较别致。
具体而言,栋栋的花的高度可以看成一列整数 。设当一部分花被移走后,剩下的花的高度依次为 ,则栋栋希望下面两个条件中至少有一个满足:
条件 A:对于所有的 ,有 ,同时对于所有的 ,有 ; 条件 B:对于所有的 ,有 ,同时对于所有的 ,有 。
注意上面两个条件在 时同时满足,当 时最多有一个能满足。
请问,栋栋最多能将多少株花留在原地。
输入格式
第一行包含一个整数 ,表示开始时花的株数。
第二行包含 个整数,依次为 ,表示每株花的高度。
输出格式
输出一行,包含一个整数,表示最多能留在原地的花的株数。
输入 #1
55 3 2 1 2输出 #1
3说明/提示
输入输出样例说明
有多种方法可以正好保留 株花,例如,留下第 、、 株,高度分别为 、、,满足条件 B。
数据范围
对于 的数据,;
对于 的数据,;
对于 的数据,,;
对于 的数据,,,所有的 随机生成,所有随机数服从某区间内的均匀分布。
题解 贪心
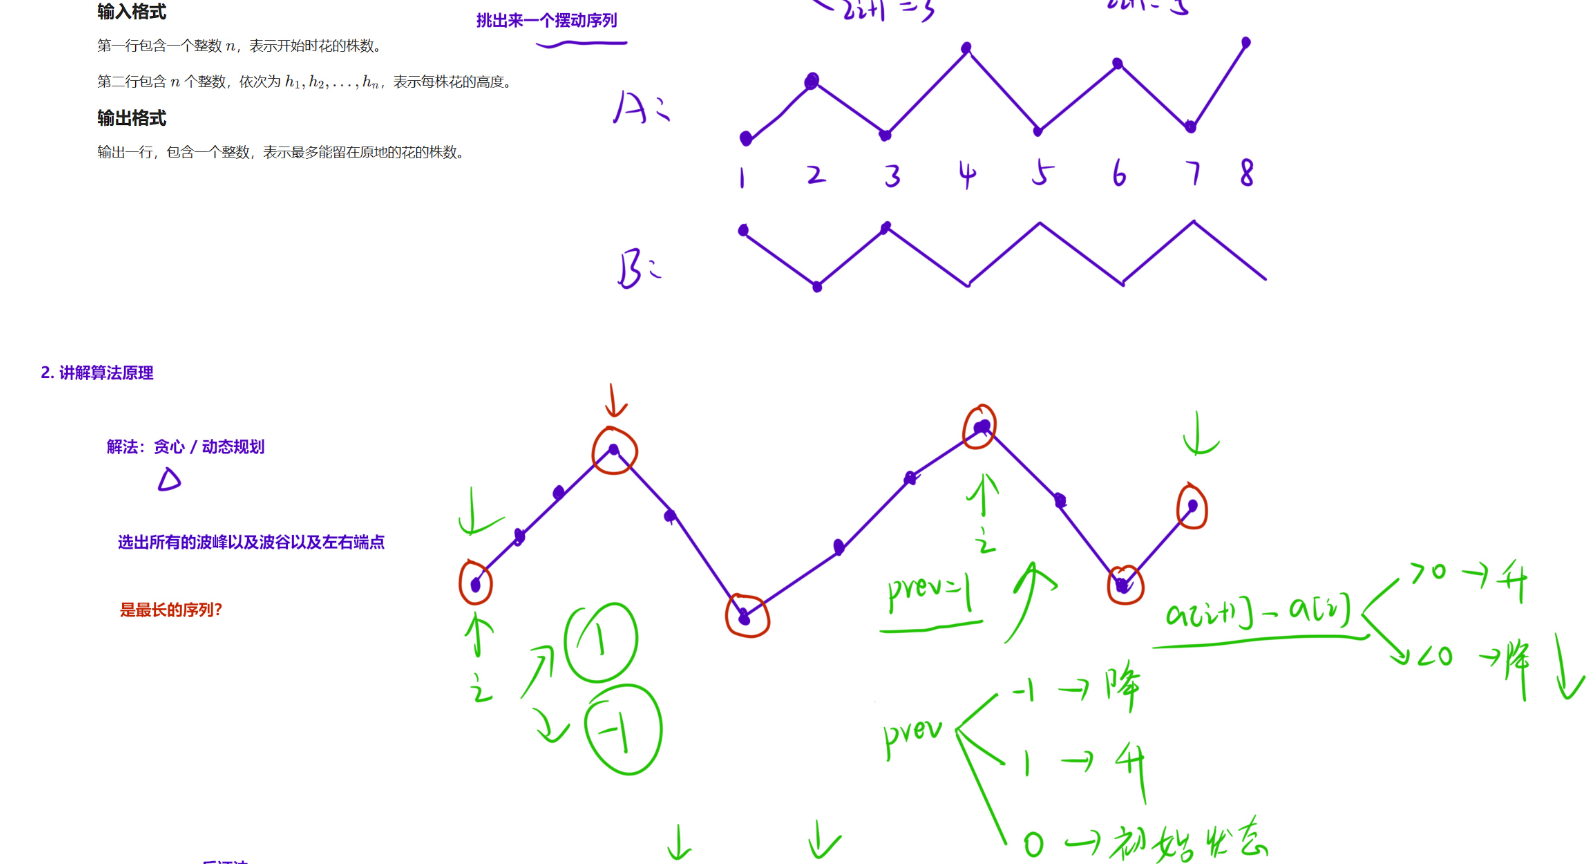 算法原理分析
题目要求留下一个“波浪形”序列,要么是“上升-下降-上升……”(条件A),要么是“下降-上升-下降……”(条件B)。本质上就是寻找一个序列,使得相邻元素的相对大小关系交替变化
- 如果接下来呈现上升趋势的话,我们让其上升到波峰的位置;
- 如果接下来呈现下降趋势的话,我们让其下降到波⾕的位置。
- 因此,如果把整个数组放在「折线图」中,我们统计出所有的波峰以及波⾕的个数即可
**特殊情况处理
- 相邻元素相等:直接跳过,不影响趋势判断
- 全相等序列:cnt=0,结果为1,只留一朵花
- 单调序列:只有一次趋势,结果为2
#include <iostream>using namespace std;
const int N = 1e5 + 10;int n;int h[N];
int main() { cin >> n; for(int i = 1; i <= n; i++) cin >> h[i];
int prev = 0; // 上一个趋势:0表示初始,1表示上升,-1表示下降 int cnt = 0; // 趋势变化次数(即极值点个数)
for(int i = 1; i < n; i++) { int d = h[i + 1] - h[i]; if(d == 0) continue; // 高度相等不影响趋势 d = (d > 0 ? 1 : -1); // 归一化:只关心方向
if(d != prev) cnt++; // 趋势发生变化,说明i是极值点 prev = d; // 更新趋势 }
// 趋势变化次数+1 = 波峰波谷总数+1 = 最终序列长度 cout << cnt + 1 << endl;
return 0;}隐讳的完全背包问题
P5020 货币系统
题目描述
在网友的国度中共有 种不同面额的货币,第 种货币的面额为 ,你可以假设每一种货币都有无穷多张。为了方便,我们把货币种数为 、面额数组为 的货币系统记作 。
在一个完善的货币系统中,每一个非负整数的金额 都应该可以被表示出,即对每一个非负整数 ,都存在 个非负整数 满足 的和为 。然而, 在网友的国度中,货币系统可能是不完善的,即可能存在金额 不能被该货币系统表示出。例如在货币系统 , 中,金额 就无法被表示出来。
两个货币系统 和 是等价的,当且仅当对于任意非负整数 ,它要么均可以被两个货币系统表出,要么不能被其中任何一个表出。
现在网友们打算简化一下货币系统。他们希望找到一个货币系统 ,满足 与原来的货币系统 等价,且 尽可能的小。他们希望你来协助完成这个艰巨的任务:找到最小的 。
输入格式
输入文件的第一行包含一个整数 ,表示数据的组数。
接下来按照如下格式分别给出 组数据。 每组数据的第一行包含一个正整数 。接下来一行包含 个由空格隔开的正整数 。
输出格式
输出文件共有 行,对于每组数据,输出一行一个正整数,表示所有与 等价的货币系统 中,最小的 。
输入 #1
243 19 10 6511 29 13 19 17输出 #1
25说明/提示
在第一组数据中,货币系统 和给出的货币系统 等价,并可以验证不存在 的等价的货币系统,因此答案为 。 在第二组数据中,可以验证不存在 的等价的货币系统,因此答案为 。
【数据范围与约定】
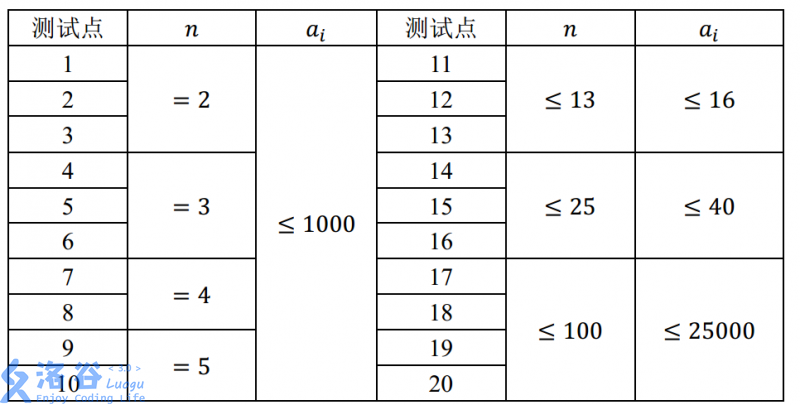
对于 的数据,满足 。
题解-贪心+完全背包
问题本质理解
题目要求:给定一个货币系统 (n, a),找一个与之等价的货币系统 (m, b),使得 m 最小。
关键观察:
- 较⼤的数只能由较⼩的⼀些数组合出来,因此我们可以先对原数组排序;
- 如果⼀个数 a[i] 能被 [1,i − 1] 区间内的数表⽰,那么就可以舍去;如果不能,那就必须保留。
- 那解法就显⽽易⻅了,先对整个数组排序,然后从前往后做完全背包问题。状态表示为从前
i个数中挑选,是否能凑成整数j。在循环到a[i]的时候,去看看dp[i − 1][a[i]]是否是` true。
完全背包
- 状态定义:
f[j]表示金额j是否能被已经考虑过的数表示 - 初始化:
f[0] = true(金额0总是能被表示) - 遍历每个数
a[i]:- 如果
f[a[i]] == true:说明a[i]能被前面的数组合出来,可以删除 - 如果
f[a[i]] == false:说明a[i]不能被前面的数组合,必须保留 - 更新背包:用
a[i]更新所有能表示的金额
- 如果
一句话解释
-
排序:保证小面额在前,因为大面额不可能表示小面额
-
判断:如果当前面额无法被已保留的小面额组合出来,说明它是新的“基底”,必须保留
-
更新:无论是否保留,都要用它更新背包,确保后续判断正确
#include <iostream>#include <algorithm>#include <cstring>using namespace std;
const int N = 110, M = 25010; // N: 最大货币种类数,M: 最大金额限制(25010 > 25000)int n; // 当前货币系统种类数int a[N]; // 存储货币面额bool f[M]; // 动态规划数组,f[j]表示金额j是否能被已保留的货币表示
void solve(){ cin >> n; // 输入货币种类数
// 1. 输入所有货币面额 for(int i = 1; i <= n; i++) cin >> a[i];
// 2. 对货币面额排序(从小到大) // 排序原因:较小的数不能由较大的数组合,便于贪心处理 sort(a + 1, a + 1 + n);
// 3. 初始化动态规划数组 memset(f, 0, sizeof f); // 所有金额初始化为不可表示 f[0] = true; // 金额0总是可表示(不选任何货币)
int ret = 0; // 记录最少需要保留的货币种类数
// 4. 遍历每个货币面额 for(int i = 1; i <= n; i++) { // 关键判断:如果a[i]不能被前面已保留的货币组合出来 // 则a[i]必须保留(因为它是"基底"元素) if(!f[a[i]]) ret++;
// 完全背包更新: // 如果a[i]被保留(上面判断为true),则用它更新所有可表示的金额 // 如果a[i]不被保留(上面判断为false),也应该用它更新吗? // 注意:即使a[i]不被保留,它仍然可以用,因为题目允许使用所有面额 // 所以这里需要更新,保证背包状态完整 for(int j = a[i]; j <= a[n]; j++) { // f[j] = f[j] OR f[j - a[i]] // 表示金额j要么原来就能表示,要么用a[i]加上j-a[i]能表示 f[j] = f[j] || f[j - a[i]]; } }
// 5. 输出结果:最少的必要货币种类数 cout << ret << endl;}
int main(){ int T; // 测试数据组数 cin >> T;
// 处理每组测试数据 while(T--) { solve(); // 调用求解函数 }
return 0;}kk算法/最小生成树
P1396 营救
题目背景
“咚咚咚……”“查水表!”原来是查水表来了,现在哪里找这么热心上门的查表员啊!小明感动得热泪盈眶,开起了门……
题目描述
妈妈下班回家,街坊邻居说小明被一群陌生人强行押上了警车!妈妈丰富的经验告诉她小明被带到了 区,而自己在 区。
该市有 条大道连接 个区,一条大道将两个区相连接,每个大道有一个拥挤度。小明的妈妈虽然很着急,但是不愿意拥挤的人潮冲乱了她优雅的步伐。所以请你帮她规划一条从 至 的路线,使得经过道路的拥挤度最大值最小。
输入格式
第一行有四个用空格隔开的 ,,,,其含义见【题目描述】。
接下来 行,每行三个整数 ,表示有一条大道连接区 和区 ,且拥挤度为 。
两个区之间可能存在多条大道。
输出格式
输出一行一个整数,代表最大的拥挤度。
输入 #1
3 3 1 31 2 22 3 11 3 3输出 #1
2说明/提示
数据规模与约定
- 对于 的数据,保证 。
- 对于 的数据,保证 。
- 对于 的数据,保证 ,,,。且从 出发一定能到达 区。
样例输入输出 1 解释
小明的妈妈要从 号点去 号点,最优路线为 。
题解-kk算法/最小生成树
问题理解 这是一个”最小化路径上最大边权”的问题
- 从起点s到终点t
- 经过的路径中,最大的边权要尽可能小
- 相当于找一条从s到t的路径,使得路径上的瓶颈最小
**核心思想:最小生成树(Kruskal算法思想)
- 将所有边按拥挤度(边权)从小到大排序
- 依次加入边,用并查集维护连通性
- 当s和t第一次连通时,最后加入的那条边的权值就是答案
#include <iostream>#include <algorithm>using namespace std;
const int N = 1e4 + 10, M = 2e4 + 10; // N:最大节点数,M:最大边数
int n, m, s, t; // n:区数,m:道路数,s:起点,t:终点
// 边的结构体struct node{ int u, v, w; // u,v:连接的两个区,w:拥挤度(边权)}e[M];
// 比较函数:按拥挤度升序排序bool cmp(node& x, node& y){ return x.w < y.w;}
// 并查集部分int fa[N]; // 并查集父节点数组
// 查找根节点(带路径压缩)int find(int x){ // 如果x是根节点,直接返回 // 否则,递归查找并压缩路径 return x == fa[x] ? x : fa[x] = find(fa[x]);}
// 合并两个集合void un(int x, int y){ // 将x的根节点的父亲设为y的根节点 fa[find(x)] = find(y);}
int main(){ // 读入数据 cin >> n >> m >> s >> t;
// 读入所有道路信息 for(int i = 1; i <= m; i++) cin >> e[i].u >> e[i].v >> e[i].w;
// 1. 按拥挤度从小到大排序所有边 sort(e + 1, e + 1 + m, cmp);
// 2. 初始化并查集:每个节点自成一个集合 for(int i = 1; i <= n; i++) fa[i] = i;
// 3. 初始化答案为最大边的权值(最坏情况) int ret = e[m].w;
// 4. 按权值从小到大依次加入边 for(int i = 1; i <= m; i++) { int u = e[i].u, v = e[i].v, w = e[i].w;
// 合并u和v所在的集合 un(u, v);
// 更新答案为当前边的权值 ret = w;
// 检查起点s和终点t是否连通 // 如果连通,说明找到了一条路径,其最大边权就是当前边权w if(find(s) == find(t)) break; // 找到答案,退出循环 }
// 5. 输出结果 cout << ret << endl;
return 0;}01BFS
# P1948 Telephone Lines S
题目描述
多年以后,笨笨长大了,成为了电话线布置师。由于地震使得某市的电话线全部损坏,笨笨是负责接到震中市的负责人。该市周围分布着 ()根按 顺序编号的废弃的电话线杆,任意两根线杆之间没有电话线连接,一共有 ()对电话杆可以拉电话线。其他的由于地震使得无法连接。
第 对电线杆的两个端点分别是 ,它们的距离为 ()。数据中每对 只出现一次。编号为 的电话杆已经接入了全国的电话网络,整个市的电话线全都连到了编号 的电话线杆上。也就是说,笨笨的任务仅仅是找一条将 号和 号电线杆连起来的路径,其余的电话杆并不一定要连入电话网络。
电信公司决定支援灾区免费为此市连接 ()对由笨笨指定的电话线杆,对于额外的那些电话线,需要为它们付费,总费用决定于其中最长的电话线的长度(每根电话线仅连接一对电话线杆)。如果需要连接的电话线杆不超过 对,那么支出为 。
请你计算一下,将电话线引到震中市最少需要在电话线上花多少钱?
输入格式
输入文件的第一行包含三个数字 。
第二行到第 行,每行分别都为三个整数 。
输出格式
一个整数,表示该项工程的最小支出,如果不可能完成则输出 。
输入 #1
5 7 11 2 53 1 42 4 83 2 35 2 93 4 74 5 6输出 #1
4题解
这是一个典型的二分答案 + 01-BFS的解题框架: 题目说:你可以免费连接 对电线杆,剩下的电线中,最长的那根就是你要付的钱。你需要让这个钱越少越好。
我们可以反过来想(这就是二分答案的精髓所在):
假设你现在心里定了一个预算目标 。
-
长度 的电线:在预算内,随便用,不需要消耗免费名额。
-
长度 的电线:超预算了!如果你必须走这条线,就必须消耗 个免费名额。
现在问题就变成了:在这个预算 下,你能不能从 1 号点走到 号点,并且消耗的免费名额不超过 个?
-
如果能走到(消耗名额 ):说明预算 是可行的,甚至可以尝试降低预算。
-
如果走不到(消耗名额 ):说明预算太紧张了,必须提高预算。
时间复杂度:O((V+E)logC),其中C是边权范围
#include <iostream>#include <deque>#include <cstring>#include <vector>
using namespace std;
typedef pair<int, int> PII; // 定义一个整数对类型,用于存储<邻接点, 边权>
const int N = 1e3 + 10; // 定义最大节点数(1000+10)
int n, p, k; // n:节点数,p:边数,k:可以免费升级的电缆数量vector<PII> edges[N]; // 邻接表存储图,edges[i]存储从节点i出发的所有边
bool st[N]; // 标记节点是否被访问过int dist[N]; // 存储从起点1到每个节点的最短距离(这里的距离是"需要付费的边数")
/** * 检查函数:判断当阈值设为x时,能否使从1到n的路径中,需要付费的边数 ≤ k * 思路:将边权 > x 的边视为1(需要付费),边权 ≤ x 的边视为0(可以免费) * 然后求从1到n的最短路径(即需要付费的边数的最小值) */bool check(int x){ // 初始化 memset(st, 0, sizeof st); memset(dist, 0x3f, sizeof dist); // 初始化为无穷大
// 01-BFS:双端队列实现0-1边权的最短路 deque<int> q; q.push_back(1); // 从节点1开始 dist[1] = 0; // 到起点的距离为0
while(q.size()) { int a = q.front(); q.pop_front(); // 取出队首节点 if(st[a]) continue; // 如果已经访问过,跳过 st[a] = true; // 标记为已访问
// 遍历节点a的所有邻接边 for(auto& t : edges[a]) { int b = t.first, // 邻接点 c = t.second > x ? 1 : 0; // 根据阈值x重新定义边权:>x的需要付费(1),≤x的免费(0)
// 如果找到更短的路径(需要付费的边数更少) if(dist[a] + c < dist[b]) { dist[b] = dist[a] + c; // 0-1 BFS核心:边权0的边插入队首(优先扩展),边权1的边插入队尾 if(c) q.push_back(b); // 边权为1,插入队尾 else q.push_front(b); // 边权为0,插入队首 } } }
// 返回从1到n是否可以用不超过k条付费边 return dist[n] <= k;}
int main(){ // 输入:节点数n,边数p,可以免费升级的电缆数量k cin >> n >> p >> k;
// 读入p条边的信息,构建邻接表(无向图) for(int i = 1; i <= p; i++) { int a, b, c; cin >> a >> b >> c; edges[a].push_back({b, c}); // a->b,边权为c edges[b].push_back({a, c}); // b->a,边权为c }
/** * 二分答案:找最小的阈值x,使得存在一条路径,其中大于x的边数不超过k * 相当于"第k+1大的边的最小值"问题 */ int l = 0, r = 1e6; // 二分范围:边权在0~1e6之间 while(l < r) { int mid = (l + r) / 2; if(check(mid)) r = mid; // 如果mid可行,尝试更小的值 else l = mid + 1; // 如果mid不可行,需要更大的值 }
// 输出结果:如果无法到达n(dist[n]为无穷大),输出-1,否则输出最小的阈值 if(dist[n] == 0x3f3f3f3f) cout << -1 << endl; else cout << l << endl;
return 0;}P12135 [蓝桥杯 2025 省 B] 水质检测
题目描述
小明需要在一条 的河床上铺设水质检测器。在他铺设之前,河床上已经存在一些检测器。如果两个检测器上下或者左右相邻,那么这两个检测器就是互相连通的。连通具有传递性,即如果 和 连通, 和 连通,那么 和 也连通。现在他需要在河床上增加铺设一些检测器使得所有的检测器都互相连通。他想知道最少需要增加铺设多少个检测器?
输入格式
输入共两行,表示一个 的河床。
每行一个长度为 的字符串,仅包含 # 和 .,其中 # 表示已经存在的检测器,. 表示空白。
输出格式
输出共 行,一个整数表示答案。
输入 #1
.##.....#.#.#.#...输出 #1
5样例说明
其中一种方案:
.###....#.#.######增加了 5 个检测器。
评测用例规模与约定
对于 的评测用例,保证 。
题解
01BFS:
从最左边的某⼀个 # 出发, 遇到 . 需要加⼀个检测器,遇到 # ⽆需任何操作。
那么,相当于就是从左侧的 # 出发,⾛向⾛右侧的 # ,如果在每一层扩散中遇到了#以为着他们相同边权为0.如果遇到.代表边权为1,需要增加一个检测器
注意bfs为解决最短路,第一次出队列的为到达该点的最短路,注意剪枝判断和结果更新时机
#include <iostream>#include <queue>#include <cstring>using namespace std;
const int N = 1e6 + 10;int n;char g[2][N]; // 存储2行N列的网格,'#'表示障碍物,其他字符表示空地int dist[2][N]; // 记录从起点到每个点的最短距离(经过的障碍物数量)bool st[2][N]; // 标记每个点是否已确定最短距离
int dx[] = {0, 0, 1, -1}; // 上下左右四个方向int dy[] = {1, -1, 0, 0};
// 0-1 BFS算法,返回从(i,j)出发能到达的最远障碍物的距离(经过的最少障碍物数量)int bfs(int i, int j){ int ret = 0; // 记录最大距离 memset(dist, 0x3f, sizeof dist); // 初始化距离为无穷大 deque<pair<int, int>> q; // 双端队列,用于0-1 BFS q.push_back({i, j}); // 起点入队 dist[i][j] = 0; // 起点距离为0
while(q.size()) { auto t = q.front(); q.pop_front(); // 取出队首元素 int a = t.first, b = t.second;
if(st[a][b]) continue; // 已确定最短距离,跳过 st[a][b] = true; // 标记为已确定
if(g[a][b] == '#') ret = max(ret, dist[a][b]); // 如果是障碍物,更新最大距离
for(int k = 0; k < 4; k++) // 遍历四个方向 { int x = a + dx[k], y = b + dy[k]; if(x < 0 || x >= 2 || y < 0 || y >= n || st[x][y]) continue; // 越界或已访问
int w = g[x][y] == '#' ? 0 : 1; // 障碍物权值为0,空地权值为1 dist[x][y] = min(dist[a][b] + w, dist[x][y]); // 更新最短距离
// 0-1 BFS核心:权值为0的边入队首,权值为1的边入队尾 if(w) q.push_back({x, y}); // 权值1 → 队尾 else q.push_front({x, y}); // 权值0 → 队首 } } return ret;}
int main(){ cin >> g[0] >> g[1]; // 输入两行字符串 n = strlen(g[0]); // 获取列数
// 找到第一个障碍物作为起点 for(int j = 0; j < n; j++) { if(g[0][j] == '#') { cout << bfs(0, j) << endl; // 从第一行该列开始BFS return 0; } if(g[1][j] == '#') { cout << bfs(1, j) << endl; // 从第二行该列开始BFS return 0; } }
// 没有障碍物的情况 cout << 0 << endl; return 0;}DFS
P9241 飞机降落
题目描述
架飞机准备降落到某个只有一条跑道的机场。其中第 架飞机在 时刻到达机场上空,到达时它的剩余油料还可以继续盘旋 个单位时间,即它最早可以于 时刻开始降落,最晩可以于 时刻开始降落。降落过程需要 个单位时间。
一架飞机降落完毕时,另一架飞机可以立即在同一时刻开始降落,但是不能在前一架飞机完成降落前开始降落。
请你判断 架飞机是否可以全部安全降落。
输入格式
输入包含多组数据。
第一行包含一个整数 ,代表测试数据的组数。
对于每组数据,第一行包含一个整数 。
以下 行,每行包含三个整数 。
输出格式
对于每组数据,输出 YES 或者 NO,代表是否可以全部安全降落。
输入 #1
230 100 1010 10 100 2 2030 10 2010 10 2020 10 20输出 #1
YESNO说明/提示
【样例说明】
对于第一组数据,可以安排第 3 架飞机于 0 时刻开始降落,20 时刻完成降落。安排第 2 架飞机于 20 时刻开始降落,30 时刻完成降落。安排第 1 架飞机于 30 时刻开始降落,40 时刻完成降落。
对于第二组数据,无论如何安排,都会有飞机不能及时降落。
【评测用例规模与约定】
对于 的数据,。
对于 的数据,,,。
蓝桥杯 2023 省赛 B 组 D 题。
题解
问题描述 有n架飞机需要降落,每架飞机有三个参数:
-
t:最早可以开始降落的时间 -
d:可以等待的最大时间(最晚开始降落时间 = t + d) -
l:降落所需时间
要求判断是否存在一个降落顺序,使得所有飞机都能在各自允许的时间窗口内完成降落。
思考:先看一眼数据范围 --- 10 可以确定是dfs跑不掉,然后题目要求给一个飞机排列使其全部可以安全降落,因此要运用全排列,把所有可能排列的循序全部排列一遍,如果有一个顺序可以使全部飞机安全降落就返回true,全部没有就为false
#include<iostream>#include<cstring>using namespace std;
const int N = 12; // 飞机最大数量
// 飞机结构体:t-最早降落时间,d-可延迟时间,l-降落耗时struct node{ int t,d,l;}a[N];
int st[N]; // 标记数组,记录飞机是否已降落int n; // 飞机数量
// 深度优先搜索 pos:已降落飞机数量,end:上一架飞机完成时间bool dfs(int pos,int end){ if(pos>n)return true; // 所有飞机都成功降落
for(int i=1;i<=n;i++) // 尝试每一架飞机 { // 如果飞机未降落且当前时间不晚于最晚开始时间 if(!st[i]&&end<=a[i].t+a[i].d) { st[i]=true; // 标记该飞机降落 // 计算新的结束时间:取当前时间和最早时间的大值 + 降落耗时 int k = max(end,a[i].t)+a[i].l; if(dfs(pos+1,k))return true; // 递归下一架 st[i]=false; // 回溯,取消标记 } } return false; // 没有可行方案}
int main(){ int t; cin>>t; // 测试数据组数 while(t--) { memset(st,0,sizeof st); // 初始化标记数组 cin>>n; // 输入每架飞机的参数 for(int i=1;i<=n;i++)cin>>a[i].t>>a[i].d>>a[i].l;
// 从第1架飞机开始,初始结束时间为0 if(dfs(1,0))cout<<"YES"<<endl; else cout<<"NO"<<endl; } return 0;}P9234 买瓜 - 剪枝
题目描述
小蓝正在一个瓜摊上买瓜。瓜摊上共有 个瓜,每个瓜的重量为 。小蓝刀功了得,他可以把任何瓜劈成完全等重的两份,不过每个瓜只能劈一刀。
小蓝希望买到的瓜的重量的和恰好为 。
请问小蓝至少要劈多少个瓜才能买到重量恰好为 的瓜。如果无论怎样小蓝都无法得到总重恰好为 的瓜,请输出 。
输入格式
输入的第一行包含两个整数 ,用一个空格分隔,分别表示瓜的个数和小蓝想买到的瓜的总重量。
第二行包含 个整数 ,相邻整数之间使用一个空格分隔,分别表示每个瓜的重量。
输出格式
输出一行包含一个整数表示答案。
输入 #1
3 101 3 13输出 #1
2评测用例规模与约定
对于 的评测用例,;
对于 的评测用例,;
对于所有评测用例,,,。
题解
这是一个DFS + 剪枝的搜索问题:
-
状态定义:
(pos, cnt, x)表示当前处理到第pos个瓜,已经劈了cnt刀,当前总重量为x -
三种选择:
-
买整个:重量+a[pos],劈刀数不变
-
买一半:重量+a[pos]/2,劈刀数+1
-
不买:重量不变,劈刀数不变
-
-
剪枝策略:
-
最优性剪枝:
cnt >= ret,当前劈刀数已经不可能更优 -
可行性剪枝:
x > m,重量已超目标 -
可行性剪枝:
x + f[pos] < m,后面全买也不够 -
排序优化:从大到小排序,优先处理大瓜
-
-
目标:找到达到总重量m的最小劈刀次数
#include<iostream>#include<algorithm>using namespace std;const int N = 35; // 最多30个瓜,开大一点typedef long long LL;int n,m; // n:瓜的数量,m:目标重量int a[N]; // 存储每个瓜的重量LL f[N]; // 后缀和数组,f[i]表示从第i个到第n个瓜的总重量LL ret=0x3f3f3f3f; // 记录最少劈瓜次数,初始化为一个很大的数
// 比较函数,用于从大到小排序bool cmp(int x,int y){ return x>y;}
// DFS搜索函数// pos:当前处理到第几个瓜// cnt:已经劈了多少刀(买一半的次数)// x:当前已买到的总重量void dfs(LL pos, LL cnt, double x){ // 如果当前重量恰好等于目标重量 if(x == m) { ret = min(ret, cnt); // 更新最少劈瓜次数 return; }
// 如果所有瓜都处理完了 //注意处理顺序哦,得让它更新一下再判断是否处理完,最后一个瓜进函数是n+1 if(pos > n) return;
// 如果当前劈瓜次数已经大于等于已知最优解,剪枝 if(cnt >= ret) return;
// 如果当前重量已经超过目标重量,剪枝 if(x > m) return;
// 如果即使把后面所有瓜都买整个也达不到目标,剪枝 if(x + f[pos] < m) return;
// 三种选择:
// 1. 买整个瓜(不劈) dfs(pos+1, cnt, x + a[pos]);
// 2. 买一半(劈一刀) dfs(pos+1, cnt+1, x + a[pos]/2.0);
// 3. 不买这个瓜 dfs(pos+1, cnt, x);}
int main(){ cin >> n >> m; // 输入瓜的数量和目标重量
// 输入每个瓜的重量 for(int i = 1; i <= n; i++) { cin >> a[i]; }
// 将瓜按重量从大到小排序 // 这样优先处理大瓜,能更快接近目标,便于剪枝 sort(a+1, a+1+n, cmp);
// 计算后缀和 // f[i]表示从第i个瓜到第n个瓜的总重量 for(int i = n; i >= 1; i--) { f[i] = f[i+1] + a[i]; }
// 从第1个瓜开始搜索,初始重量0,劈瓜次数0 dfs(1, 0, 0);
// 输出结果 if(ret == 0x3f3f3f3f) // 如果ret没有被更新过,说明无解 cout << -1 << endl; else cout << ret << endl;
return 0;}P10427 数字接龙 - 路径交叉剪枝
题目描述
小蓝最近迷上了一款名为《数字接龙》的迷宫游戏,游戏在一个大小为 的格子棋盘上展开,其中每一个格子处都有着一个 之间的整数。游戏规则如下:
- 从左上角 处出发,目标是到达右下角 处的格子,每一步可以选择沿着水平 / 垂直 / 对角线方向移动到下一个格子。
- 对于路径经过的棋盘格子,按照经过的格子顺序,上面的数字组成的序列要满足:。
- 途中需要对棋盘上的每个格子恰好都经过一次(仅一次)。
- 路径中不可以出现交叉的线路。例如之前有从 移动到 ,那么再从 移动到 线路就会交叉。
为了方便表示,我们对可以行进的所有八个方向进行了数字编号,如下图 所示;因此行进路径可以用一个包含 之间的数字字符串表示,如下图 是一个迷宫示例,它所对应的答案就是:。
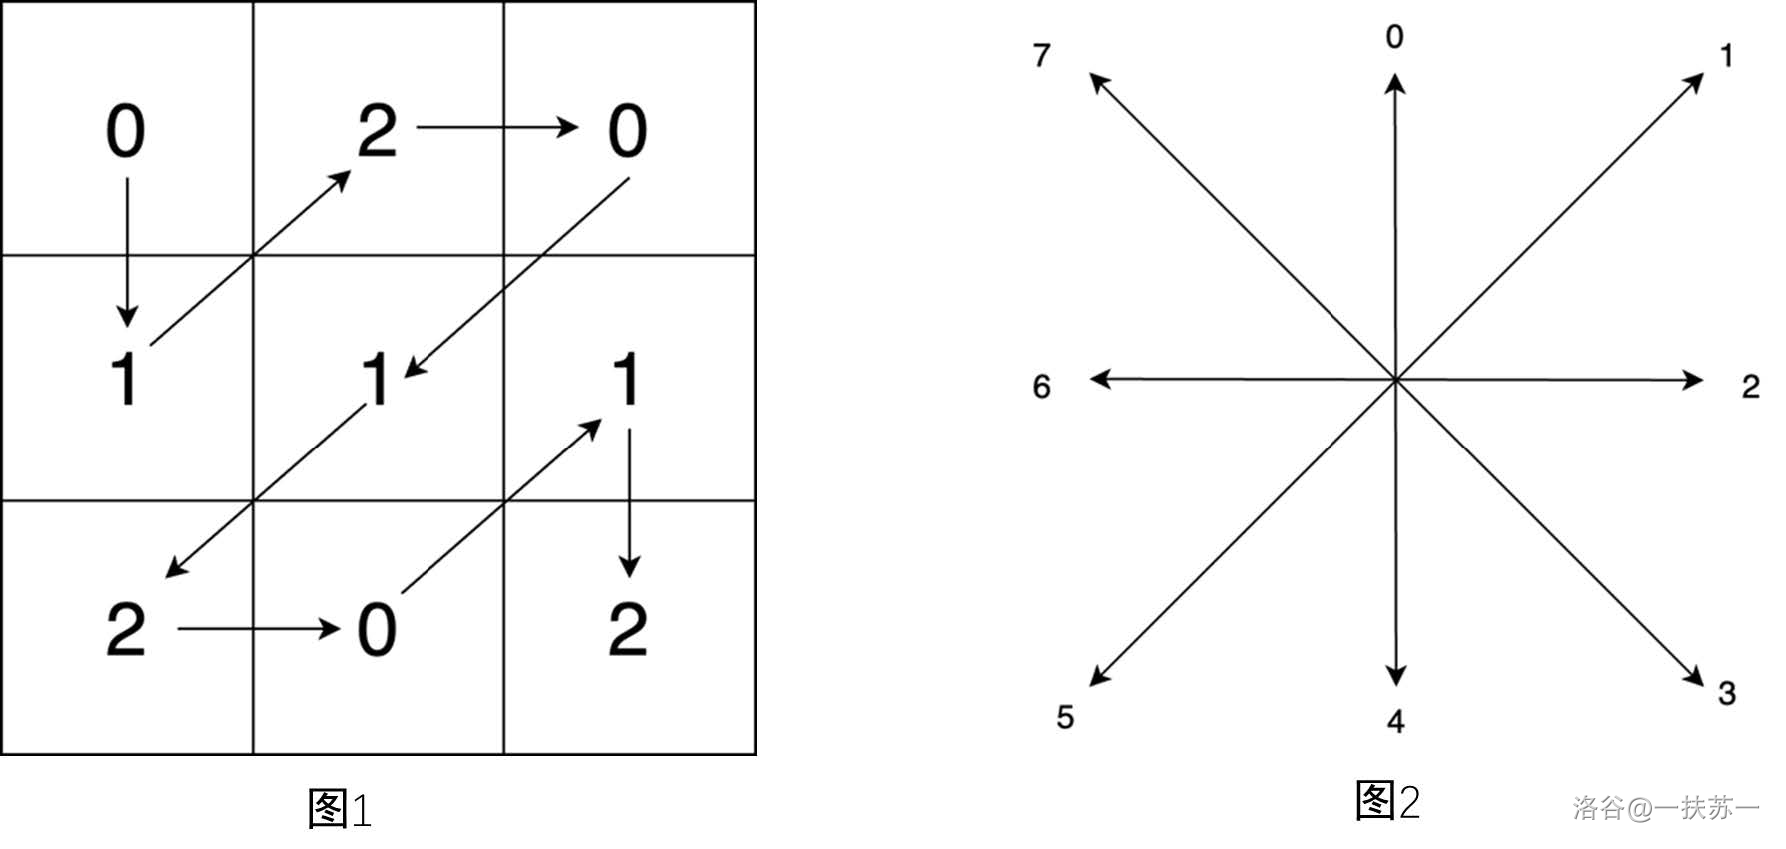
现在请你帮小蓝规划出一条行进路径并将其输出。如果有多条路径,输出字典序最小的那一个;如果不存在任何一条路径,则输出 。
输入格式
第一行包含两个整数 。 接下来输入 行,每行 个整数表示棋盘格子上的数字。
输出格式
输出一行表示答案。如果没有对应的路径,输出 。
输入 #1
3 30 2 01 1 12 0 2输出 #1
41255214数据规模与约定
- 对 的数据,。
- 对全部的测试数据,。
题解
这题的突破点是在于如何判断交叉访问
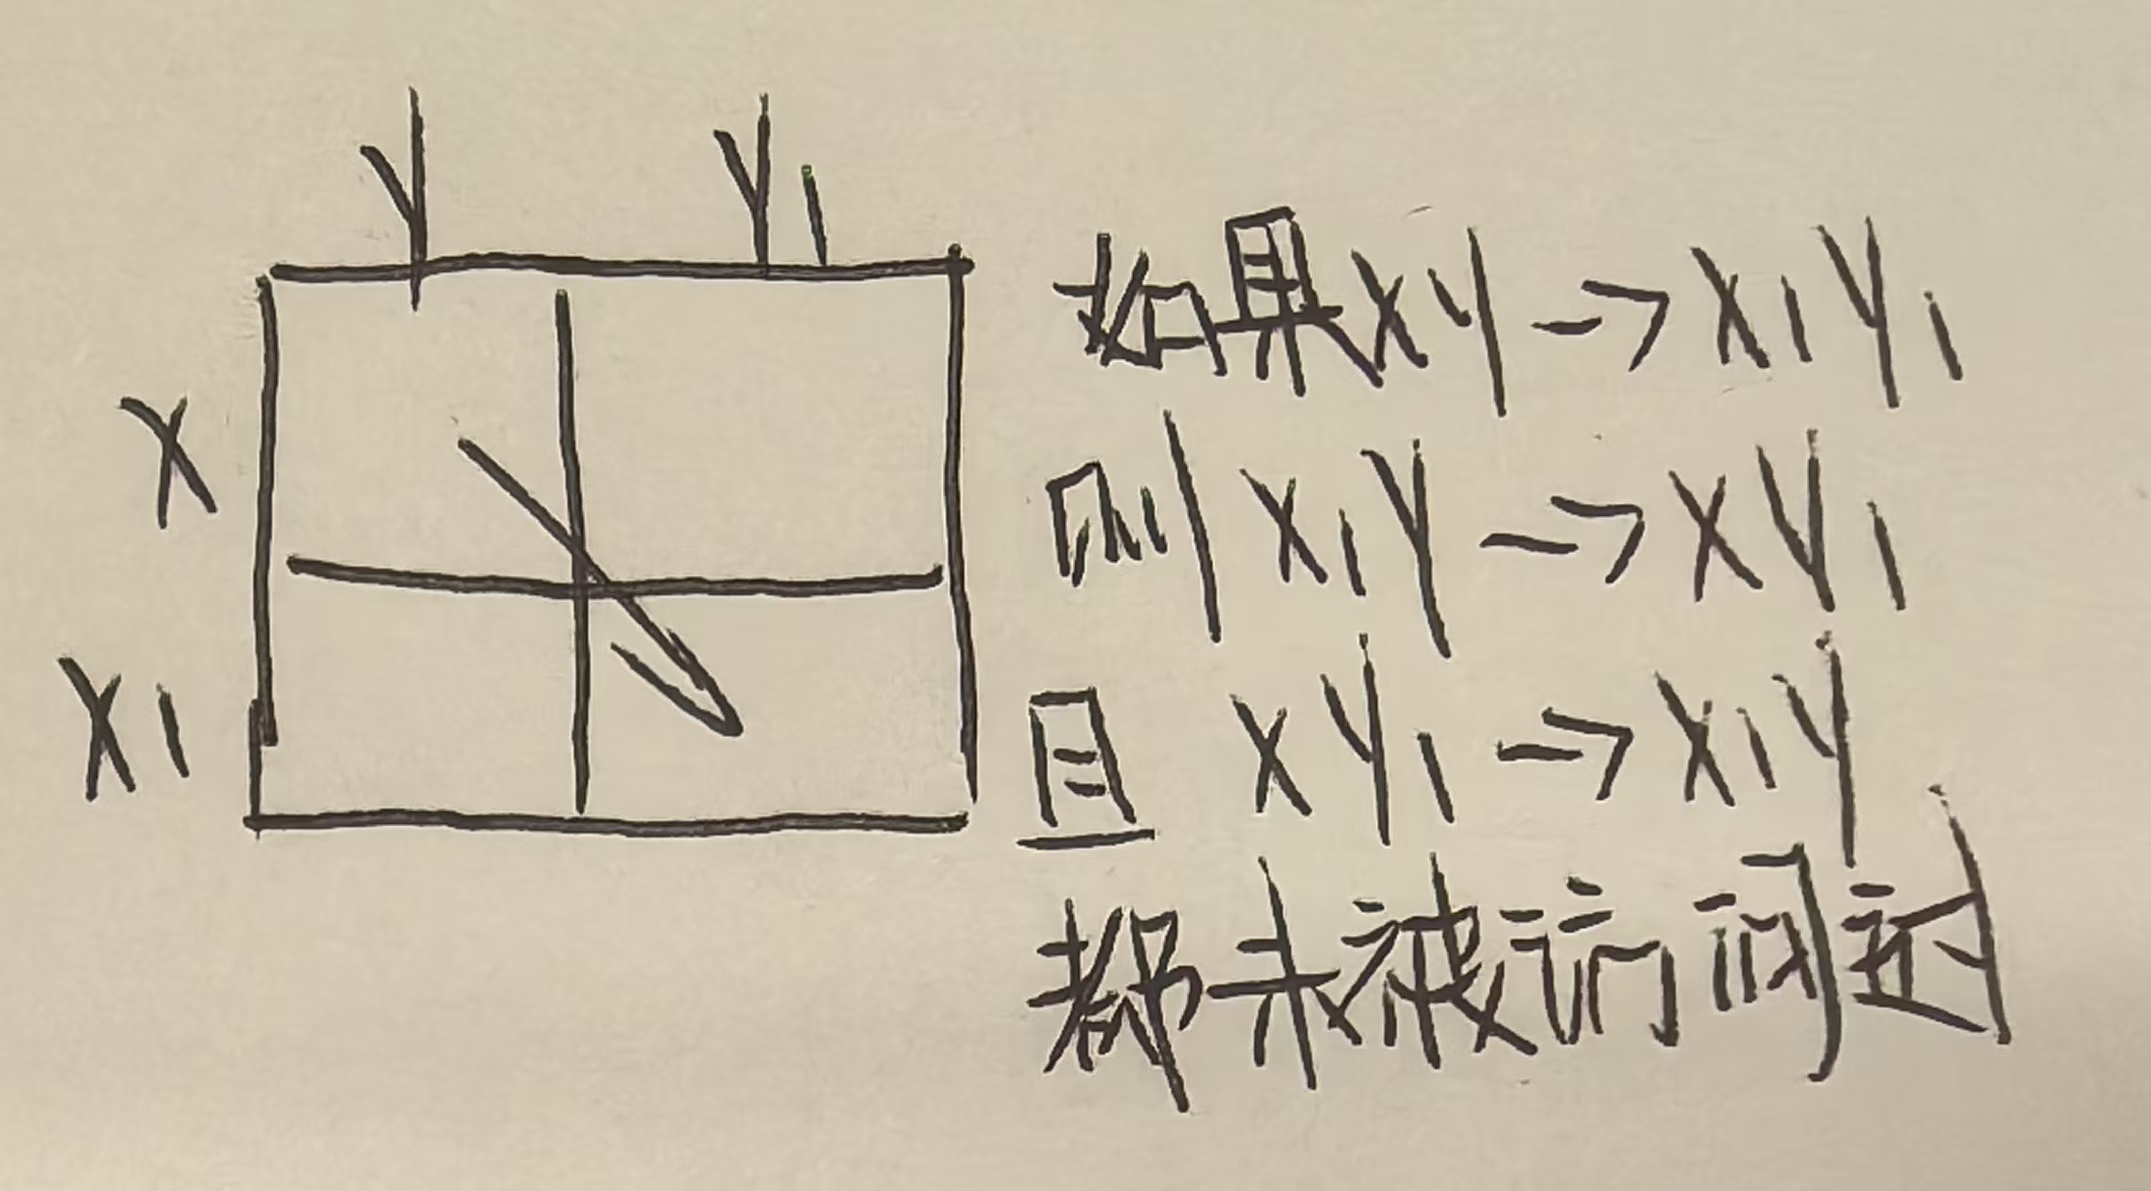 如果之前从(0,0)到(1,1),现在不能从(1,0)到(0,1)
xp[x1][y][x][y1] 表示从(x1,y)到(x,y1)的路径
xp[x][y1][x1][y]表示从(x,y1)到(x1,y)的路径
#include<iostream>#include<vector>using namespace std;
const int N = 15; // 最大棋盘大小,因为n≤10,所以15足够int n,k; // n:棋盘边长,k:数字范围(0~k-1)int a[N][N]; // 存储棋盘上每个格子的数字vector<int>ve; // 存储答案路径的方向序列(0-7的数字)
// 八个方向的偏移量数组// 顺序必须按0-7排列,这样DFS时按顺序搜索就能保证字典序最小int dx[10] = {-1,-1,0,1,1,1,0,-1}; // x方向的偏移int dy[10] = {0,1,1,1,0,-1,-1,-1}; // y方向的偏移
bool st[N][N]; // 标记格子是否已经被访问过int f=1; // 记录已经访问的格子数量(起点算1个)int xp[N][N][N][N]; // 四维数组,用于判断路径是否交叉 // xp[x1][y1][x2][y2]=true 表示从(x1,y1)到(x2,y2)的路径已经走过
/** * DFS搜索函数 * @param x, y 当前所在的格子坐标 * @param cnt 下一个格子应该匹配的数字(0~k-1循环) * @return 是否找到可行路径 */bool dfs(int x,int y,int cnt){ // 终止条件:到达右下角(n,n)并且访问了所有格子 if(x==n && y==n && f==n*n) return true;
// 按0-7的顺序尝试八个方向(保证字典序最小) for(int i=0;i<8;i++) { // 计算下一个格子的坐标 int x1 = x+dx[i], y1 = y+dy[i];
// 1. 边界检查 if(x1<1 || x1>n || y1<1 || y1>n) continue;
// 2. 数字匹配检查:下一个格子的数字必须等于cnt if(a[x1][y1] != cnt) continue;
// 3. 重复访问检查:下一个格子不能已经走过 if(st[x1][y1]) continue;
// 4. 交叉检查:检查是否与之前的路径交叉 // 交叉情况举例:之前从(0,0)到(1,1),现在不能从(1,0)到(0,1) // xp[x1][y][x][y1] 表示从(x1,y)到(x,y1)的路径 // xp[x][y1][x1][y] 表示从(x,y1)到(x1,y)的路径 if(xp[x1][y][x][y1] || xp[x][y1][x1][y]) continue;
// 所有条件都满足,选择这个方向 ve.push_back(i); // 将方向编号加入答案 st[x1][y1] = true; // 标记下一个格子已访问 xp[x][y][x1][y1] = true; // 标记当前路径段已走过 f++; // 已访问格子数+1
// 递归搜索下一步,cnt循环加1(数字序列循环) if(dfs(x1, y1, (cnt+1)%k)) return true;
// 回溯:如果上面的递归没有找到解,撤销当前选择 f--; // 格子数-1 xp[x][y][x1][y1] = false; // 取消路径标记 ve.pop_back(); // 从答案中移除方向 st[x1][y1] = false; // 取消访问标记 }
// 所有方向都尝试完还没找到解,返回false return false;}
int main(){ // 输入数据 cin>>n>>k; for(int i=1;i<=n;i++) { for(int j=1;j<=n;j++) { cin>>a[i][j]; } }
// 从起点(1,1)开始搜索 st[1][1] = true; // 标记起点已访问 // 第三个参数是1:因为起点应该是0,所以下一个要找的数字是1 if(dfs(1,1,1)) { // 找到解,输出路径方向 for(auto p:ve) { cout<<p; } cout<<endl; } else { // 没有解,输出-1 cout<<-1<<endl; }
return 0;}P1219 八皇后 - 对角线标记剪枝
题目描述
一个如下的 的跳棋棋盘,有六个棋子被放置在棋盘上,使得每行、每列有且只有一个,每条对角线(包括两条主对角线的所有平行线)上至多有一个棋子。
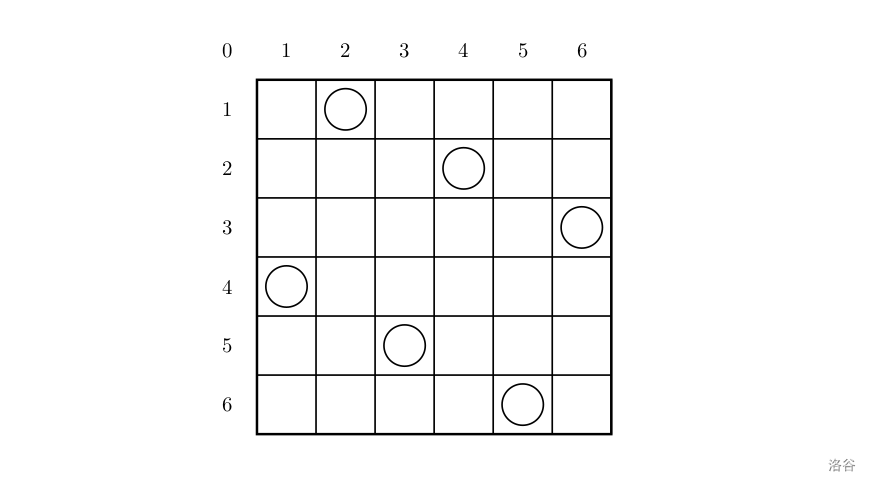
上面的布局可以用序列 来描述,第 个数字表示在第 行的相应位置有一个棋子,如下:
行号
列号
这只是棋子放置的一个解。请编一个程序找出所有棋子放置的解。 并把它们以上面的序列方法输出,解按字典顺序排列。 请输出前 个解。最后一行是解的总个数。
输入格式
一行一个正整数 ,表示棋盘是 大小的。
输出格式
前三行为前三个解,每个解的两个数字之间用一个空格隔开。第四行只有一个数字,表示解的总数。
输入 #1
6输出 #1
2 4 6 1 3 53 6 2 5 1 44 1 5 2 6 34说明/提示
【数据范围】 对于 的数据,。
题目翻译来自NOCOW。
USACO Training Section 1.5
题解
-
状态表示:
-
st1[y]:标记第y列是否被占用 -
st2[y-x+n]:标记主对角线(左上到右下),特点:同一主对角线上y-x为常数 -
st3[x+y]:标记副对角线(右上到左下),特点:同一副对角线上x+y为常数
-
-
对角线索引计算:
-
主对角线:
y-x的范围是[-(n-1), n-1],加n后映射到[1, 2n-1] -
副对角线:
x+y的范围是[2, 2n],直接作为索引
-
-
回溯算法:
-
逐行尝试放置皇后
-
对于每个合法位置,标记占用后递归下一行
-
递归返回后撤销标记(回溯)
-
-
字典序输出:
- 由于列
y是从小到大尝试的,所以解自动按字典序排列
- 由于列
#include<iostream>#include<vector>using namespace std;const int N = 15;
vector<vector<int>> ve; // 存储所有解的容器,每个解是一个vector<int>bool st1[N]; // 列标记数组:st1[y]=true 表示第y列已有皇后bool st2[2*N]; // 主对角线标记数组(左上-右下方向)bool st3[2*N]; // 副对角线标记数组(右上-左下方向)int n; // 棋盘大小 n×nvector<int> path; // 存储当前正在构建的解,path[i]表示第i行皇后所在的列int ret; // 解的总数计数器
/** * 深度优先搜索函数 * @param x 当前要放置皇后的行号(从1开始) * * 思路:逐行放置皇后,保证每行只有一个皇后 * 对于当前行x,尝试将皇后放在每一列y上 */void dfs(int x){ // 基础情况:已经放置完所有行(x从1到n) if(x > n){ ve.push_back(path); // 将当前解存入ve容器 ret++; // 解的总数加1 return ; }
// 尝试将当前行x的皇后放在第y列 for(int y = 1; y <= n; y++) { // 检查位置(x,y)是否合法: // st1[y]:第y列是否已有皇后 // st2[y-x+n]:主对角线是否已有皇后(y-x为常数,+n防止负数索引) // st3[x+y]:副对角线是否已有皇后(x+y为常数) if(st1[y] || st2[y-x+n] || st3[x+y]) continue; // 不合法,尝试下一列
// 选择当前位置 path.push_back(y); // 将当前列号加入路径 st1[y] = st2[y-x+n] = st3[x+y] = true; // 标记该列和两条对角线已被占用 dfs(x + 1); // 递归处理下一行
// 回溯:撤销选择,恢复状态 path.pop_back(); st1[y] = st2[y-x+n] = st3[x+y] = false; }}
int main(){ cin >> n; // 输入棋盘大小 dfs(1); // 从第1行开始搜索
// 输出前3个解 int cnt = 0; for(auto u : ve) // 遍历所有解 { cnt++; if(cnt > 3) break; // 只输出前3个 for(auto v : u) // 输出当前解的每一列 { cout << v << " "; } cout << endl; } cout << ret << endl; // 输出解的总数 return 0;}P10386 [蓝桥杯 2024 省 A] 五子棋对弈
题目描述
“在五子棋的对弈中,友谊的小船说翻就翻?” 不!对小蓝和小桥来说,五子棋不仅是棋盘上的较量,更是心与心之间的沟通。这两位挚友秉承着 “友谊第一,比赛第二” 的宗旨,决定在一块 的棋盘上,用黑白两色的棋子来决出胜负。但他们又都不忍心让对方失落,于是决定用一场和棋(平局) 作为彼此友谊的见证。 比赛遵循以下规则:
- 棋盘规模:比赛在一个 的方格棋盘上进行,共有 个格子供下棋使用。
- 棋子类型:两种棋子,黑棋与白棋,代表双方。小蓝持白棋,小桥持黑棋。
- 先手规则:白棋(小蓝)具有先手优势,即在棋盘空白时率先落子(下棋)。
- 轮流落子:玩家们交替在棋盘上放置各自的棋子,每次仅放置一枚。
- 胜利条件:率先在横线、竖线或斜线上形成连续的五个同色棋子的一方获胜。
- 平局条件:当所有 个棋盘格都被下满棋子,而未决出胜负时,游戏以平局告终。
在这一设定下,小蓝和小桥想知道,有多少种不同的棋局情况(终局不同看成不同情况,终局相同而落子顺序不同看成同一种情况),既确保棋盘下满又保证比赛结果为平局。
输入格式
这是一道结果填空题,你只需要算出结果后提交即可。本题的结果为一个整数,在提交答案时只填写这个整数,填写多余的内容将无法得分。
输出格式
这是一道结果填空题,你只需要算出结果后提交即可。本题的结果为一个整数,在提交答案时只填写这个整数,填写多余的内容将无法得分。
题解
如果要要考虑白棋黑棋轮流下的话,代码会非常难写,因此只考虑当前格子白棋下与不下两种选择,然后依据题目来写条件与返回值
#include<iostream>using namespace std;
const int N = 10; // 数组大小,取10足够(实际只需要6)
int st1[N]; // st1[i]:第i行中白棋的数量(i从1到5)int st2[N]; // st2[i]:第i列中白棋的数量(i从1到5)int st3; // 主对角线(左下到右上,即x=y)上的白棋数量int st4; // 副对角线(左上到右下,即x+y=6)上的白棋数量int ret = 0; // 满足条件的方案总数(即平局棋局的数量)
bool check(){ // 检查5行和5列 for(int i = 1; i <= 5; i++) { // 如果某行没有白棋(0)或全是白棋(5),则该行全黑或全白,有连五,不是平局 if(st1[i] == 0 || st1[i] == 5) return false; // 如果某列没有白棋(0)或全是白棋(5),则该列全黑或全白,有连五,不是平局 if(st2[i] == 0 || st2[i] == 5) return false; } // 检查主对角线:如果没有白棋(0)或全是白棋(5),则该对角线全黑或全白,有连五 if(st3 == 0 || st3 == 5) return false; // 检查副对角线:如果没有白棋(0)或全是白棋(5),则该对角线全黑或全白,有连五 if(st4 == 0 || st4 == 5) return false;
return true; // 所有行、列、对角线都满足白棋数在1~4之间,即为平局}
// 深度优先搜索枚举所有放置13个白棋的方案// x, y: 当前正在决策的格子坐标(1-based,x行y列)// cnt: 已经放置的白棋数量void dfs(int x, int y, int cnt){ // 已经放置了13个白棋,说明25个格子已确定(13白+12黑) if(cnt == 13) { // 检查当前棋局是否为平局 if(check()) ret++; // 是平局,方案数加1 return; }
// 列坐标越界:当前行已处理完,换到下一行开头 if(y > 5){ x++; y = 1; }
// 行坐标越界:所有格子都已处理完毕 if(x > 5) { return; }
// ========== 分支1:在当前位置(x,y)下白棋 ========== st1[x]++; // 第x行白棋数+1 st2[y]++; // 第y列白棋数+1 if(x - y == 0) st3++; // 如果在主对角线上,主对角线白棋数+1 if(x + y == 6) st4++; // 如果在副对角线上,副对角线白棋数+1 dfs(x, y + 1, cnt + 1); // 递归处理下一个格子,已放白棋数+1 // 回溯:恢复现场,以便尝试其他分支 st1[x]--; st2[y]--; if(x - y == 0) st3--; if(x + y == 6) st4--;
// ========== 分支2:在当前位置(x,y)不下白棋(即下黑棋) ========== dfs(x, y + 1, cnt); // 递归处理下一个格子,已放白棋数不变}
int main(){ dfs(1, 1, 0); // 从第1行第1列开始搜索,初始已放置0个白棋 cout << ret << endl; // 输出平局棋局的数量 return 0;}Floodfill问题
P9243 岛屿个数
题目描述
小蓝得到了一副大小为 的格子地图,可以将其视作一个只包含字符 0(代表海水)和 1(代表陆地)的二维数组,地图之外可以视作全部是海水,每个岛屿由在上/下/左/右四个方向上相邻的 1 相连接而形成。
在岛屿 所占据的格子中,如果可以从中选出 个不同的格子,使得他们的坐标能够组成一个这样的排列:,其中 是由 通过上/下/左/右移动一次得来的(),此时这 个格子就构成了一个「环」。如果另一个岛屿 所占据的格子全部位于这个「环」内部,此时我们将岛屿 视作是岛屿 的子岛屿。若 是 的子岛屿, 又是 的子岛屿,那 也是 的子岛屿。
请问这个地图上共有多少个岛屿?在进行统计时不需要统计子岛屿的数目。
输入格式
第一行一个整数 ,表示有 组测试数据。
接下来输入 组数据。对于每组数据,第一行包含两个用空格分隔的整数 表示地图大小;接下来输入 行,每行包含 个字符,字符只可能是 0 或 1。
输出格式
对于每组数据,输出一行,包含一个整数表示答案。
输入 #1
25 501111110011010110001111115 6111111100001010101100001111111输出 #1
13说明/提示
【样例说明】
对于第一组数据,包含两个岛屿,下面用不同的数字进行了区分:
0111111001102011000111111岛屿 2 在岛屿 1 的「环」内部,所以岛屿 2 是岛屿 1 的子岛屿,答案为 。
对于第二组数据,包含三个岛屿,下面用不同的数字进行了区分:
111111100001020301100001111111注意岛屿 3 并不是岛屿 1 或者岛屿 2 的子岛屿,因为岛屿 1 和岛屿 2 中均没有「环」。
【评测用例规模与约定】
对于 的评测用例,。
对于 的评测用例,, 。
蓝桥杯 2023 省赛 B 组 F 题。
题解
算法原理:Floodfill - 这类问题大多数都要依赖外海解决
这道题的核心是统计不被其他岛屿包围的岛屿数量,即排除子岛屿。关键点在于如何判断一个岛屿是否被另一个岛屿的”环”包围。
1. 问题理解
-
岛屿:四方向连通的1构成的区域
-
子岛屿:被另一个岛屿的”环”完全包围的岛屿
-
环:岛屿中能构成一个闭合回路的格子集合
-
最终答案:所有非子岛屿的数量
2. 核心思路 判断一个岛屿是否被包围,等价于判断这个岛屿是否与外部海水连通。如果能从岛屿出发到达地图外的海水,说明它没有被完全包围。
-
将地图扩展一圈,最外层全部视为海水(0)
-
从地图外的海水开始DFS/BFS
-
能访问到的海水是”外海”
-
能访问到的陆地是”不被包围的岛屿”
-
被包围的岛屿(子岛屿)无法被访问到
3.双DFS策略:
-
dfs0:海水搜索(8方向,包括对角线)
-
dfs1:陆地搜索(4方向,标准岛屿连通)
为什么海水用8方向? 因为环可能很薄,只有通过对角线才能”钻”进环的内部。8方向保证海水能通过任何缝隙进入环内。
为什么陆地用4方向? 因为岛屿定义就是四方向相邻,这是题目规定的。
4. 算法流程
-
地图扩展:创建(n+2)×(m+2)的地图,边界全部为0(海水)
-
从(0,0)开始海水DFS:
-
如果遇到海水(0),继续8方向探索
-
如果遇到陆地(1),切换为陆地DFS
-
每发现一个陆地岛屿,计数器+1
-
-
陆地DFS:标记整个岛屿,不计数(因为已经在海水DFS中计数)
图例
0111111001101011000111111扩展后(加一圈海水0):
0000000001111001100100101010010001001111100000000从(0,0)开始海水DFS:
-
沿着外围海水探索,遇到陆地就标记为岛屿
-
内部的岛屿(被环包围)接触不到外部海水,不会被计数
代码
#include<iostream>#include<cstring>using namespace std;const int N = 60; // 地图最大尺寸
int a[N][N]; // 地图数组:0表示海水,1表示陆地int st[N][N]; // 访问标记数组,true表示已访问
// 方向数组:前4个是上下左右(用于陆地),后4个是对角线(用于海水)int dx[10] = {0,0,1,-1,1,1,-1,-1};int dy[10] = {1,-1,0,0,1,-1,1,-1};
int cnt = 0; // 岛屿计数器(只统计不被包围的岛屿)
// dfs1:陆地深度优先搜索(4方向)// 作用:标记整个岛屿的所有陆地格子void dfs1(int i,int j,int n,int m){ st[i][j]=true; // 标记当前陆地格子已访问
// 4方向探索:上下左右 for(int k=0;k<4;k++) { int x = i+dx[k], y = j+dy[k];
// 越界检查(地图范围是1~n, 1~m) if(x<1||x>n||y<1||y>m) continue; // 已访问检查 if(st[x][y]) continue; // 如果是陆地,继续递归探索 if(a[x][y]) dfs1(x,y,n,m); }}
// dfs0:海水深度优先搜索(8方向)// 作用:从外部海水开始,探索所有能到达的海水区域// 当遇到陆地时,触发dfs1标记整个岛屿,并计数void dfs0(int i,int j,int n,int m){ st[i][j]=true; // 标记当前海水格子已访问
// 8方向探索:上下左右 + 四个对角线 for(int k=0;k<8;k++) { int x = i+dx[k], y = j+dy[k];
// 越界检查(范围扩展到0~n+1, 0~m+1,包含外围海水) if(x<0||x>n+1||y<0||y>m+1) continue; // 已访问检查 if(st[x][y]) continue;
if(a[x][y]){ // 如果遇到陆地格子 dfs1(x,y,n,m); // 调用dfs1标记整个岛屿 cnt++; // 岛屿计数器加1(发现一个新岛屿) } else // 如果遇到海水格子 dfs0(x,y,n,m); // 继续海水探索 }}
int main(){ int t; // 测试数据组数 cin>>t;
while(t--) { int n,m; // 当前地图的行数和列数
// 初始化:清空标记数组和地图数组 memset(st,0,sizeof st); memset(a,0,sizeof a); // 将所有格子初始化为0(海水) cnt = 0; // 重置计数器
cin>>n>>m;
// 输入地图数据,从(1,1)开始存储 for(int i=1;i<=n;i++) { for(int j=1;j<=m;j++) { char s; cin>>s; a[i][j] = s-'0'; // 字符转数字:'0'->0, '1'->1 } }
// 从地图外的位置(0,0)开始海水DFS // 注意:地图实际范围是1~n,1~m,0和n+1,m+1都是扩展的海水区域 dfs0(0,0,n,m);
// 输出当前测试数据的答案 cout<<cnt<<endl; }
return 0;}
/*算法思路总结:1. 将地图扩展一圈,外围全部视为海水(0)2. 从(0,0)开始8方向DFS探索海水 - 8方向保证海水能通过对角线进入环内3. 遇到陆地(1)时,切换为4方向DFS标记整个岛屿 - 4方向符合岛屿定义 - 每遇到一个陆地岛屿,计数器+14. 最终计数结果就是所有不被包围的岛屿数量
核心思想:只有能从外部海水到达的陆地才是独立岛屿被环包围的子岛屿无法被外部海水访问到,因此不会被计数*/贪心
P10902 [蓝桥杯 2024 省 C] 回文数组
题目描述
小蓝在无聊时随机生成了一个长度为 的整数数组,数组中的第 个数为 ,他觉得随机生成的数组不太美观,想把它变成回文数组,也是就对于任意 满足 。小蓝一次操作可以指定相邻的两个数,将它们一起加 或减 ;也可以只指定一个数加 或减 ,请问他最少需要操作多少次能把这个数组变成回文数组?
输入格式
输入的第一行包含一个正整数 。
第二行包含 个整数 ,相邻整数之间使用一个空格分隔。
输出格式
输出一行包含一个整数表示答案。
输入 #1
41 2 3 4输出 #1
3说明/提示
【样例说明】
第一次操作将 加 ,变为 ;
后面两次操作将 加 ,变为 。
【评测用例规模与约定】
对于 的评测用例,; 对于所有评测用例,,。
题解
贪心+分类讨论: 依题可知:只要让左半部分变得和右半部分的数相等即可,那么我们可以维护一个差值数组b[i]; b[i]=a[n+1-i]-a[i]; 从后往前遍历差值数组并进行分类讨论
- 如果当前差值为0(b[i]==0 )则无需操作,直接下一个数
- 如果当前差值数与下一个数异号(b[i]与b[i+1]符号不同),只能对当前差值进行加减,不能带着下一个数字一起操作
- 如果当前差值与下一位同号,则可以一起加减,但下一位只能加这两个数的最小值,,如果当前i位没有加减到0,则要继续单独操作
#include<iostream>#include<cmath> // 使用abs函数using namespace std;
typedef long long LL; // 使用long long防止溢出const int N = 1e5 + 10; // 数组最大长度int n;LL a[N]; // 原数组LL b[N]; // 差值数组,b[i] = a[n-i+1] - a[i]
int main(){ cin >> n; for(int i = 1; i <= n; i++) cin >> a[i];
// 计算对称位置的差值 // 目标:让a[i]和a[n-i+1]相等 // 差值b[i]表示需要调整的量(b[i]>0表示右边大,需要减小右边或增大左边) for(int i = 1; i <= n / 2; i++) { b[i] = a[n - i + 1] - a[i]; }
LL ret = 0; // 记录最少操作次数
// 从左到右处理差值 for(int i = 1; i <= n / 2; i++) { if(b[i] == 0) continue; // 已经相等,无需操作
// 如果是最后一个对称对,直接操作 if(i == n / 2){ ret += abs(b[i]); // 每次只能单点操作,需要|b[i]|次 break; }
// 先加上当前差值的绝对值(至少需要这些单点操作) ret += abs(b[i]);
// 关键优化:如果相邻两个差值同号,可以用相邻操作合并 // 相邻操作可以同时影响两个差值,减少操作次数
if(b[i] > 0 && b[i + 1] > 0) { // 两个都是正数,说明右边都偏大 // 可以用相邻操作同时减少右边两个数(或增加左边两个数) // 能合并的次数是较小的那个 int k = min(b[i], b[i + 1]); b[i + 1] -= k; // 下一个差值减去已合并的部分 } else if(b[i] < 0 && b[i + 1] < 0) { // 两个都是负数,说明左边都偏大 // 可以用相邻操作同时增加右边两个数(或减少左边两个数) int k = min(abs(b[i]), abs(b[i + 1])); b[i + 1] += k; // 负数加上k,绝对值减小 } // 如果异号,无法用相邻操作合并 }
cout << ret << endl; return 0;}前缀和
P10903 [蓝桥杯 2024 省 C] 商品库存管理
题目描述
在库存管理系统中,跟踪和调节商品库存量是关键任务之一。小蓝经营的仓库中存有多种商品,这些商品根据类别和规格被有序地分类并编号,编号范围从 至 。初始时,每种商品的库存量均为 。
为了高效地监控和调整库存量,小蓝的管理团队设计了 个操作,每个操作涉及到一个特定的商品区间,即一段连续的商品编号范围(例如区间 )。执行这些操作时,区间内每种商品的库存量都将增加 。然而,在某些情况下,管理团队可能会决定不执行某些操作,使得这些操作涉及的商品区间内的库存量不会发生改变,维持原有的状态。
现在,管理团队需要一个评估机制,来确定如果某个操作未被执行,那么最终会有多少种商品的库存量为 。对此,请你为管理团队计算出,对于每个操作,如果不执行该操作而执行其它操作,库存量为 的商品的种类数。
输入格式
输入的第一行包含两个整数 和 ,分别表示商品的种类数和操作的个数。
接下来的 行,每行包含两个整数 和 ,表示一个操作涉及的商品区间。
输出格式
输出 行,每行一个整数,第 行的整数表示如果不执行第 个操作,则最终库存量为 的商品种类数。
输入 #1
5 31 22 43 5输出 #1
101说明/提示
【样例说明】
考虑不执行每个操作时,其余操作对商品库存的综合影响:
-
不执行操作 :剩余的操作是操作 (影响区间 )和操作 (影响区间 )。执行这两个操作后,商品库存序列变为 。在这种情况下,只有编号为 的商品的库存量为 。因此,库存量为 的商品种类数为 。
-
不执行操作 :剩余的操作是操作 (影响区间 )和操作 (影响区间 )。执行这两个操作后,商品库存序列变为 。在这种情况下,所有商品的库存量都不为 。因此,库存量为 的商品种类数为 。
-
不执行操作 :剩余的操作是操作 (影响区间 )和操作 (影响区间 )。执行这两个操作后,商品库存序列变为 。在这种情况下,只有编号为 的商品的库存量为 。因此,库存量为 的商品种类数为 。
【评测用例规模与约定】
对于 的评测用例,,。 对于所有评测用例,,。
题解
差分+前缀和:
- 所有的操作都是让区间内每一个元素增加1,因此可以用差分数组快速还原出所有操作之后原数组;
- 当某一个区间操作
[l,r]撤销时,只有这个区间内的1会在操作撤销后变成0,因此可以用前缀和统计出每次操作后[1,i]区间内1的个数,每次撤销之后,查询撤销区间内1的个数即可; - 原本为0的也是答案因此答案为区间1的个数+本来就为0的个数
反思: 正确的前缀和维护的是原库存有多少个1(1-1为0),而超时的前缀和用来每次还原区间数组思考与使用方式不一样导致算法错误
#include<iostream>using namespace std;
const int N = 3e5 + 10;int f[N];int n, m;struct node { int l, r;} a[N];int sum[N];
int main(){ cin >> n >> m; for (int i = 1; i <= m; i++) { cin >> a[i].l >> a[i].r; f[a[i].l] += 1; f[a[i].r + 1] -= 1; }
int zero = 0; // 存储即使不执行也为0的个数
// 还原出原数组,用前缀和维护(1,i)中库存为1的数量 for (int i = 1; i <= n; i++) { f[i] = f[i - 1] + f[i]; if (f[i] == 0) zero++; if (f[i] == 1) sum[i] = sum[i - 1] + 1; else sum[i] = sum[i - 1]; }
for (int i = 1; i <= m; i++) { cout << sum[a[i].r] - sum[a[i].l - 1] + zero << endl; }
return 0;}模拟(精度问题)
P12313 蓝桥杯 2024 国 C 存钱
题目描述
小蓝将钱存在了银行,每天银行会按照小蓝存款的 给予小蓝一定的利息,上一天结束时的存款余额会在下一天开始时参与利息的计算,余额的最小单位为 元( 分),每天的利息小于 元的部分忽略不计。
给定小蓝在 天内的存取记录,求小蓝每天结束时的存款数量。
一开始小蓝的余额为 ,保证任何时候取出的钱不会超出余额。
输入格式
输入的第一行包含一个整数 表示天数。
接下来 行,每行包含一个实数 ,小数位数不超过 位,表示小蓝在第 天的净存取量(正数表示存款,负数表示取款, 表示不存不取,单位为元)。
输出格式
输出 行,每行包含一个实数 ,保留正好两位小数,表示第 天结束时小蓝存款的余额(单位为元)。
输入 #1
410000.00-10000.01300.01500.02输出 #1
10000.000.49300.50800.53评测用例规模与约定
- 对于 的评测用例,,;
- 对于所有评测用例,,, 的小数点后最多只有两位数字。
题解
解题思路
本题是一道典型的金融类模拟题,最大的陷阱是浮点数精度丢失。如果直接用 double 存储“元”并在每次循环中进行小数乘法和加法,由于 IEEE 754 浮点数标准的底层二进制表示缺陷,极易在多次累加后产生微小的误差,导致最终结果错位。
为了彻底规避精度问题,核心思路可归纳为以下三点:
1. 核心策略:降维打击(化“元”为“分”)
在所有涉及货币计算的算法中,最优解通常是统一转换到最小面值单位进行整数运算。
题目中提到最小单位为 0.01 元(1 分),因此我们在读入数据时,立刻将其乘以 100,把状态维护的基准从“元(浮点数)”全部转换为“分(大整数)”。这样后续所有的本金累加操作,就都变成了绝对安全的整数加法。
2. 破局点:对冲读入时的浮点误差
在使用化“元”为“分”的策略时,会遇到一个次生问题:读入带两位小数的浮点数并乘以 100 时,可能会发生精度微调(例如输入 300.01,底层可能是 300.009999…,乘 100 并向下取整会变成 30000 分而不是 30001 分)。
思路是在乘 100 后,不使用强制类型转换的默认向下截断,而是使用四舍五入(round 或 llround)。这一步是保证原始数据转换成“分”时不差一毫的关键。
3. 顺水推舟:处理“不足 1 分忽略不计”的规则
题目要求“每天的利息小于 0.01 元的部分忽略不计”。因为我们此时的余额单位已经是“分”,利息的计算公式变为:利息(分) = 余额(分) * 0.00005。
这个计算结果可能带有小数。由于 C/C++ 中浮点数赋值给整型变量(如 long long)时,会自动向下取整(截断小数部分),这个语言特性正好完美契合了题目中“忽略不计”的业务逻辑要求。我们不需要使用任何复杂的 floor 函数,直接利用隐式类型转换即可。
总结算法流程
-
初始化:读取第一天的存款,乘以 100 并四舍五入,存入代表“分”的变量中。
-
状态转移:从第二天起,遍历每一天:
-
用当前的“分”乘以 0.00005,利用整型截断算出当天合法的利息分。
-
将利息分加到本金分上。
-
读入当天的净存取量,同样乘 100 并四舍五入转为“分”,加到本金上。
-
-
输出收尾:输出时,直接将内部维护的“分”除以 100.0,通过格式化控制输出两位小数,即可还原成题目要求的“元”。
代码
#include<iostream>#include<cmath>using namespace std;
// 虽然这里声明为 double,但在实际计算中,它存储的是乘以 100 后的“分”double x;
int main(){ int n; cin >> n; // 读入总天数 M
cin >> x; // 读入第一天的净存取量(单位:元) n--; // 第一天不产生利息,单独处理,剩余循环天数减 1
// 核心策略:将金额单位从“元”转换为“分”,彻底规避后续累加的浮点数精度丢失 // 使用 llround() 四舍五入,是为了防止类似 300.01 在底层表示为 300.00999... 时,向下取整导致少算 1 分钱 x = llround(x * 100);
// 此时 x 存储的数值单位是“分”,输出时除以 100 即可还原为“元” printf("%.2f\n", x / 100);
// 遍历剩下的 n 天 while(n--) { // 题目要求利息是 0.005%,因为 x 的单位已经是“分”,所以直接乘 0.00005 // 赋值给 long long 类型的 lixi,利用 C++ 浮点数转整数会自动向下截断小数部分的特性, // 完美实现了题目“不足 1 分忽略不计”的要求 long long lixi = x * 0.00005;
// 将当天产生的利息累加到本金(分)中 x += lixi;
double k; cin >> k; // 读入当天的净存取量(元)
// 同样化“元”为“分”,并用 llround 修正浮点数读取时的潜在微小误差 k = llround(k * 100);
// 存取量累加到本金中 x += k;
// 结算当天余额,除以 100 转换回“元”并保留两位小数输出 printf("%.2f\n", x / 100); }
return 0;}文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!